Нашли неточность или есть что добавить? Напишите автору
Восстанавливать нормальную работу услуги как можно быстрее и с понятным приоритетом.
Зачем управление инцидентами
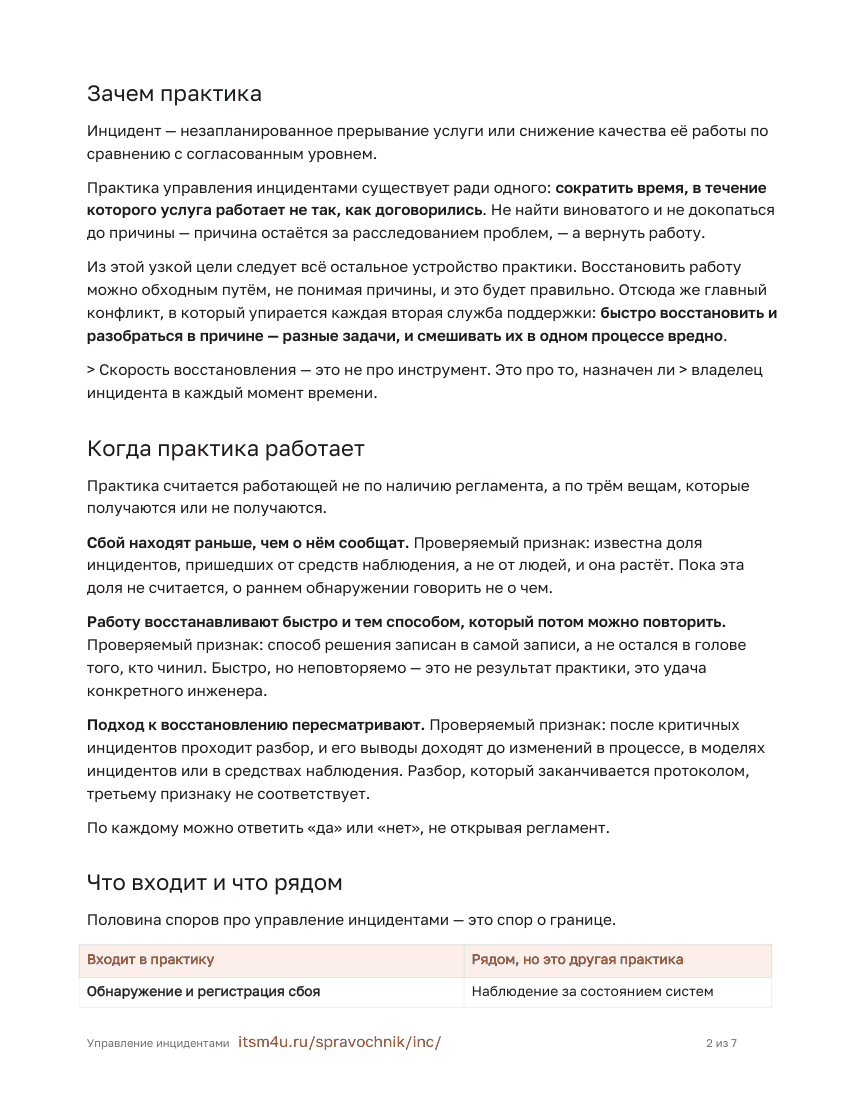
Управление инцидентами — это работа ИТ-службы по возвращению услуги в нормальное состояние всякий раз, когда услуга сломалась или стала работать хуже, чем договорились. Услуга здесь — то, чем люди пользуются в работе: почта, кассовая программа, портал заявок. Сам инцидент коротко определяет ITIL 4 — свод правил по управлению ИТ-услугамиУслугаСпособ дать потребителю нужный результат, не перекладывая на него управление затратами и рисками.ITIL 4, книга ITIL Foundation, на котором держится эта страница: незапланированное прерывание ИТ-услуги или снижение её качества 1. ПрактикаПрактикаНабор ресурсов организации для выполнения работы определённого типа.ITIL 4 существует ради одного: сократить время, в течение которого услуга работает не так, как договорились. Не найти виноватого и не докопаться до причины — устранение причины остаётся за PRBУправление проблемами, — а вернуть работу.
Из этой узкой цели следует остальное устройство практики. Работу восстанавливают обходным путёмОбходное решениеСпособ снизить или устранить последствия инцидента, когда полного решения ещё нет.ITIL 4, практическое руководство по управлению инцидентами, не понимая причины, — и это не полумера, а норма. Обходной путь — временная замена: перезапустить, перевести людей на резервный канал, сделать операцию руками. Отсюда же главный конфликт, в который я упираюсь почти в каждом проекте: быстро восстановить и разобраться в причине — разные задачи, и смешивать их в одном процессе вредно.
Обнаружение окупается раньше всего — и его же недооценивают. Сбой, найденный мониторингом до того, как о нём сообщил пользователь, обходится дешевле того же сбоя, обнаруженного звонком в службу поддержкиСлужба поддержки (service desk)Единая точка контакта между теми, кто пользуется ИТ-услугами, и теми, кто их предоставляет: сюда приходит обращение и здесь оно должно быть зафиксировано.ITIL 4, практическое руководство Service Desk; MOF 4.0. Каждая минута простоя ИТ-услуги стоит бизнесу денег, и считать её надо до того, как проектируют процесс, а не после.
ITIL 4 называет управление инцидентами одной из основ управления ИТ-услугами 1. Без него остальным практикам не на что опереться: данных о том, что и как часто ломается, просто не будет.
ИнцидентИнцидентНезапланированное прерывание услуги или снижение её качества.ITIL 4, практическое руководство по управлению инцидентами решают быстро не там, где лучше инструмент, а там, где у него в каждый момент есть владелец.
Когда практика работает
Практика считается работающей не по наличию регламента, а по трём признакам — они либо есть, либо нет 1. К ним стоит возвращаться по ходу чтения: почти каждый следующий раздел объясняет, как добиться одного из них.
Сбой находят раньше, чем о нём сообщат. Как проверить: известна доля инцидентов, пришедших от мониторинга, а не от людей, и она растёт. Пока эта доля не считается, судить о раннем обнаружении не по чему: его просто не измеряют. Там, где мониторинг сбой не поймал, остаётся человек, и его важно не отучить сообщать: ITIL 4 советует поощрять сообщения о странном поведении систем и в разумных пределах терпеть ложные тревоги 1. Пользователь, которого один раз отчитали за ложную тревогу, второй раз не позвонит.
Работу восстанавливают быстро и тем способом, который потом можно повторить. Как проверить: способ решения дописан в саму запись, а не остался в голове того, кто чинил, и по ней же видно, кто вёл инцидент на каждом отрезке. Быстро, но неповторяемо — это не результат практики, это удача конкретного инженера.
Подход к восстановлению пересматривают. Как проверить: после критичных инцидентовКритичный инцидентИнцидент со значительным влиянием на бизнес, требующий немедленной скоординированной реакции.ITIL 4, практическое руководство по управлению инцидентами проходит разбор, и его выводы доходят до изменений в процессе, в моделях инцидентов или в мониторинге. Поимённо ITIL 4 советует разбирать три рода случаев: критичные инциденты, инциденты нового вида и те, что не уложились в срок. Остальные поштучно не разбирают. Их просматривают все разом раз в два-три месяца, а если модели и процедуры работают плохо — чаще 1. Разбор, который заканчивается протоколом, третьему признаку не соответствует.
Признаки удобны тем, что видны в работе, а не в документах: по каждому можно ответить «да» или «нет», не открывая регламент. Развёрнутая шкала — ниже, в разделе про зрелость.
Что входит и что рядом
Половина споров про управление инцидентами — это спор о границе, и каждый свод проводит её по-своему. В таблице ниже граница по ITIL 4: слева то, что практика делает сама, справа — работа, которая уходит соседям, и та практика, к которой она уходит 1.
| Входит в практику | Рядом, но это другая практика |
|---|---|
| Обнаружение и регистрация сбоя | Наблюдение за состоянием систем и правила срабатывания — EVNМониторинг и управление событиями |
| Классификация, оценка влияния и срочности | Приём и сопровождение обращений пользователей — SDKСлужба поддержки |
| Диагностика и поиск способа восстановить работу | Расследование и устранение причин, ведение известных ошибокИзвестная ошибкаПроблема с установленной причиной, для которой есть обходное решение.ITIL — PRBУправление проблемами |
| Восстановление работы, в том числе обходным путём | Внесение изменений, которых требует решение — CHNКонтроль изменений |
| Ведение записи и хода диагностики | Оформление решения в пригодный для повторного применения вид — KNWУправление знаниями |
| Оповещение бизнеса и пользователей о ходе восстановления | Договорённости о сроках восстановления — SLMУправление уровнем услуг |
| Разбор после решения | Доведение выводов разбора до изменений — IMPПостоянное улучшение |
| Отсев обращений, которые сбоем не являются | Приём и исполнение самих запросов — REQУправление запросами на обслуживание |
| Признание, что случай вышел за рамки обычного восстановления | Работа по плану восстановления после катастрофы — CONУправление непрерывностью услуг |
Отдельно про две границы, которые чаще всего стирают.
Инцидент и проблема. Практика управления инцидентами не обязана находить причину. Её задача — вернуть работу; причина остаётся отдельной работой, и заводить её надо явно, а не «заодно». Смешение даёт узнаваемый эффект: инженер держит заявку открытой, пока не поймёт, что случилось, а пользователь всё это время сидит без услуги.
Инцидент и непрерывность. Бывает отказ, который обычными силами не восстановить: потеряна площадка, повреждены данные, лёг поставщик целиком. Такой случай перестают вести как инцидент и переключаются на план восстановления после катастрофы — там другие люди, другие полномочия и право поднимать резервную площадку 1. Момент переключения описывается заранее и записывается: например, «услуга не восстановлена за четыре часа» или «повреждены данные, а не только доступ к ним». Если критерий не записан, решать придётся посреди аварии — а посреди аварии такое не решают, а откладывают, и команда продолжает чинить обычными силами то, на что обычных сил уже не хватает.
Что на входе и что на выходе
Предыдущий раздел отвечает, где у практики граница. Этот — откуда приходит работа и куда уходит результат.
Списки собраны по таблицам входов и выходов практического руководства 1: строки взяты из процессов обработки инцидента и периодического разбора, а не выведены нами.
Что приходит
- EVNМониторинг и управление событиямиданные наблюдения и событияСобытиеИзменение состояния, замеченное мониторингом.ITIL 4
- SDKСлужба поддержкиобращения пользователей
- CFGУправление конфигурациямисведения о конфигурации
- IAMУправление ИТ-активамисведения об ИТ-активах
- SCMУправление каталогом услугкаталог услуг
- SLMУправление уровнем услугсоглашения об уровне услугСоглашение об уровне услугЗаписанная договорённость поставщика и заказчика: что даёт услуга, когда доступна и как быстро её восстановят.ITIL 4: практическое руководство Service Level Management и книга ITIL Foundation, 5.2.15.1; ГОСТ Р ИСО/МЭК 20000-1-2021, пункты 3.2.16, 3.2.20, 3.2.21, 7.5.4, 8.3.2–8.3.4; FitSM-0, FitSM-1 (PR2), FitSM-2 (PR2), шаблон и образец SLA из FitSM-4; MOF 4.0, глоссарий; itSMF, «Введение в ИТ Сервис-менеджмент», 2003; Ami Nahari, «Secrets of Service Level Management», TSO, 2013; Молоткова, Сахаров, «Качество услуг ИТ-аутсорсинга», 2008; «Аутсорсинг в стратегии современного бизнеса», 2019; альманах itSMF России, 2015; «Свободный ITIL» Елхимова; Брукс, «Метрики для управления ИТ-услугами» с потребителями и поставщиками
- CAPУправление мощностью и производительностьюсведения о мощности и производительности
- CONУправление непрерывностью услугполитики и планы непрерывности
- SECУправление информационной безопасностьюполитики информационной безопасности
- PRBУправление проблемамизаписи о проблемах и известные ошибки
- KNWУправление знаниямибаза знаний
- REQУправление запросами на обслуживаниеобращения, которые оказались сбоем, а не заказом
- MOpУправление эксплуатациейсбои, найденные при регламентных работах
- DEPУправление развёртываниемсведения о развёртываниях для разбора сбоев
- DScОбеспечение безопасности данныхпорядок действий при утечке данных
Что уходит
- PRBУправление проблемамизапросы на расследование причины
- CHNКонтроль измененийзапросы на изменение
- KNWУправление знаниямипополнение базы знанийБаза знанийСобрание проверенных решений и инструкций, которыми пользуются при разборе обращений.Разбор практики управления инцидентами на портале
- SDKСлужба поддержкисообщения о статусе инцидента для пользователей
- REPИзмерение и отчётностьотчёты об инцидентах и по итогам разбора
- IMPПостоянное улучшениеинициативы по улучшению
- REQУправление запросами на обслуживаниеобращения, которые оказались заказом положенного, а не сбоем
- AVLУправление доступностьюзаписи о прерываниях услуги с отметками времени
Каждая связь в этом блоке — из одного источника1
Список входов длиннее, чем кажется на первый взгляд, — и это главный вывод из него. Управление инцидентами выглядит самой самостоятельной практикой — приняли обращение, восстановили работу, закрыли. На деле оно живёт данными почти всей остальной эксплуатации: чтобы оценить влияние, нужен состав услуги и каталог; чтобы понять срок — соглашение об уровне; чтобы не изобретать решение заново — база знаний и записи о проблемах.
Отсюда типичный сценарий неудачи. Службу поддержки запускают первой и отдельно, потому что она видна заказчику. Дальше выясняется, что приоритетПриоритизацияВыбор задач, которыми займутся первыми, когда ресурсов не хватает на все.ITIL 4, практическое руководство по управлению инцидентами ставить не по чему, влияние оценивать нечем, а половина обращений решается на второй линии повторно. Ни одна из этих бед не лечится внутри практики инцидентов — они лечатся у соседей из списка выше.
Как это работает
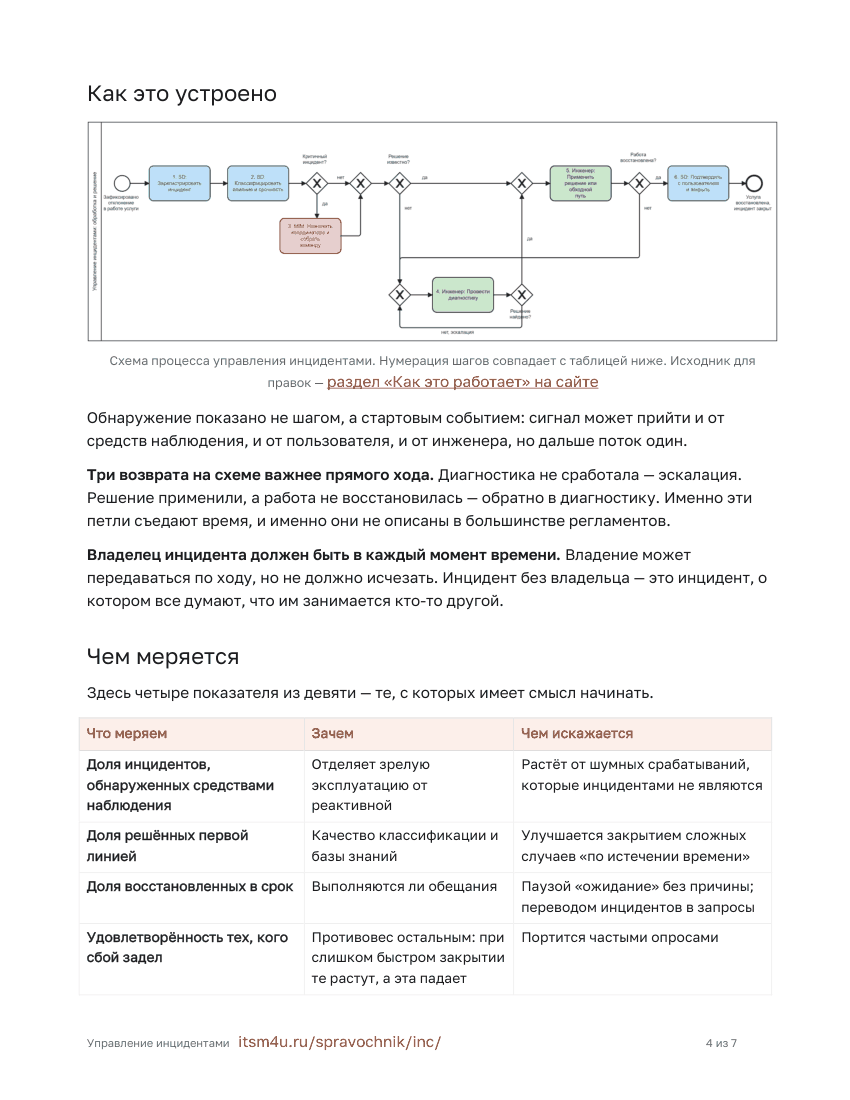
Обнаружение на схеме показано не шагом, а стартовым событием: сигнал может прийти и от мониторинга, и от пользователя, и от инженера, но дальше поток один. Нумерация шагов в таблице совпадает с номерами на схеме.
1. Зарегистрировать
- Триггер
- Поступил сигнал: обращение пользователя, событие мониторинга или наблюдение инженера
- Что делает исполнитель
- Специалист убеждается, что речь действительно об инциденте, а не о запросе на обслуживание, и заводит запись: что не работает, у кого, с какого момента
- Ответственный
- Специалист первой линииПервая линияСпециалисты, принимающие обращения и решающие типовое по базе знаний.Разбор практики управления инцидентами на портале
- Артефакт
- Запись об инциденте
2. Классифицировать
- Триггер
- Инцидент зарегистрирован
- Что делает исполнитель
- Специалист оценивает влияние и срочность, определяет затронутую ИТ-услугу и ответственную команду, связывает запись с известными ошибками и открытыми проблемами
- Ответственный
- Специалист первой линии
- Артефакт
- Запись дополнена классификацией и связями
3. Назначить координатора
- Триггер
- Классификация показала признаки критичного инцидента
- Что делает исполнитель
- Координатор собирает временную команду, открывает канал оповещения для бизнеса и пользователей и берёт владение на себя
- Ответственный
- Координатор критичного инцидента
- Артефакт
- Назначенный координатор, канал оповещения
4. Провести диагностику
- Триггер
- Готового решения нет либо применённое не сработало
- Что делает исполнитель
- Инженер воспроизводит сбой, проверяет гипотезы, при необходимости привлекает смежные команды. Каждый шаг фиксируется в записи по ходу дела, а не после
- Ответственный
- Инженер ответственной команды
- Артефакт
- Записанный ход диагностики, гипотезы и результаты проверок
5. Применить решение
- Триггер
- Решение найдено или известно из модели
- Что делает исполнитель
- Инженер применяет решение или обходной путь. Если требуется изменение — инициирует его через CHNКонтроль изменений
- Ответственный
- Инженер ответственной команды
- Артефакт
- Восстановленный элемент конфигурации, при необходимости — запрос на изменение
6. Подтвердить и закрыть
- Триггер
- Работа восстановлена
- Что делает исполнитель
- Специалист подтверждает восстановление с пользователем, дополняет запись, при необходимости инициирует разбор проблемыПроблемаПричина одного или нескольких инцидентов.ITIL и передаёт материал в KNWУправление знаниями
- Ответственный
- Специалист первой линии
- Артефакт
- Закрытая запись, заявка на разбор проблемы, черновик статьи знаний
Два возврата на схеме важнее прямого хода. Решение не нашли — эскалация и новый круг диагностики. Решение применили, а работа не восстановилась — снова туда же. Именно эти петли съедают время, и именно они не описаны в большинстве регламентов, которые я вижу у заказчиков.
Владелец инцидента должен быть в каждый момент времени 1. Владение может передаваться по ходу, но не должно исчезать. Инцидент без владельца — это инцидент, о котором все думают, что им занимается кто-то другой.
Модели инцидентов
Часть инцидентов повторяется. Для них заводят модель инцидентаМодель инцидентаЗаранее описанный повторяемый порядок обработки инцидентов одного типа.ITIL 4, практическое руководство по управлению инцидентами — заранее описанный порядок обработки конкретного типа 1. Модель ускоряет решение и делает его предсказуемым: применяется проверенный способ, а не изобретённый заново в три часа ночи.
Критичный инцидент — отдельный случай. Это инцидент с крупным влиянием на бизнес, требующий немедленной скоординированной реакции 1. Крупное влияние не единственный признак: критичный инцидент обычно ещё и сложный — например, когда несколько мелких отказов совпали и усилили друг друга. Для него в модели описывают критерий отличия от катастрофы, назначенного координатора, выделенную команду и бюджет, порядок оповещения пользователей и регуляторов и обязательный разбор после решения.
Жизненный цикл инцидента: состояния и переходы
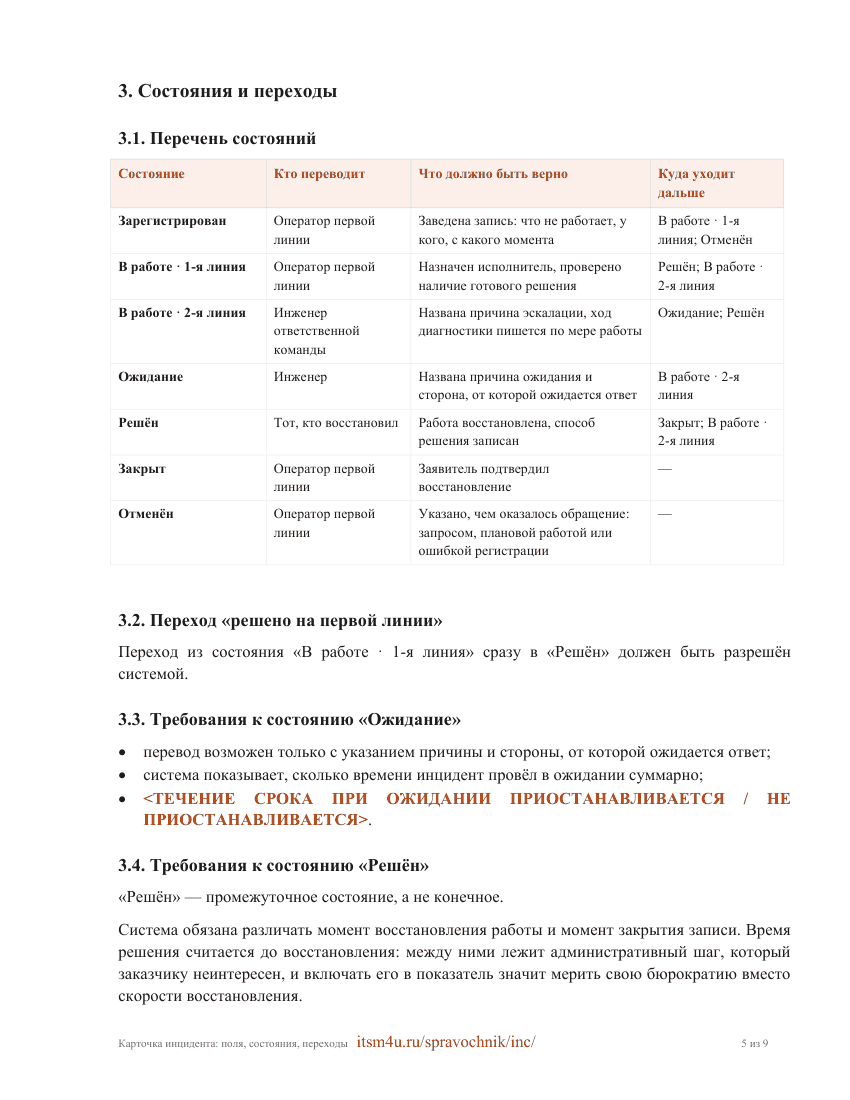
Схема выше показывает работу — кто что делает и в каком порядке. Здесь показано другое: в каких состояниях бывает сама запись и что переводит её из одного в другое. Это разные вопросы, поэтому и рисуются они по-разному.
| Состояние | Кто переводит | Что должно быть верно | Куда уходит дальше |
|---|---|---|---|
| Зарегистрирован | Специалист первой линии | Заведена запись: что не работает, у кого, с какого момента | 1-я линия, Отменён |
| В работе · 1-я линия | Специалист первой линии | Назначен исполнитель, проверено, нет ли готового решения в базе знаний | Решён, 2-я линия |
| В работе · 2-я линия | Инженер ответственной команды | Названа причина эскалацииЭскалацияПередача инцидента тем, у кого больше компетенции, либо уведомление руководителя об угрозе срока.Разбор практики управления инцидентами на портале, ход диагностики пишется по мере работы | Ожидание, Решён |
| Ожидание | Инженер ответственной команды | Названа причина ожидания и от кого ждём. Идёт срок или останавливается — решается моделью, а не каждый раз заново | 2-я линия |
| Решён | Тот, кто восстановил | Работа восстановлена, способ решения записан | Закрыт, 2-я линия |
| Закрыт | Специалист первой линии | Пользователь подтвердил восстановление | — |
| Отменён | Специалист первой линии | Указано, чем оказалось обращение: запросом, плановой работой или ошибкой регистрации | — |
Переход «решено на первой линииРешение с первого контактаДоля обращений, закрытых службой поддержки без обращения к другим уровням.ITIL Service Operation, раздел 4.2.8» важнее, чем кажется. Он идёт в обход второй линии, и доля таких закрытий — главная метрика первой линии. Если этого перехода в жизненном цикле нет, решать на первой линии просто негде: она остаётся передаточным звеном по устройству системы, а не по нежеланию людей.
Эскалация должна нести причину. Переход на вторую линию без указания, чего именно не хватило первой, — это способ избавиться от заявки, а не решить её. Записанная причина через месяц превращается в список того, чему первую линию стоит доучить.
Два состояния ломают статистику чаще прочих.
«Ожидание» — если оно останавливает срок и переводить в него может кто угодно без указания причины, метрика «закрыто в срок» перестаёт что-либо значить: любую просрочку можно спрятать, поставив паузу задним числом.
«Решён» — промежуточное состояние, а не конечное, и в этом его смысл. Между «работа восстановлена» и «пользователь подтвердил» лежит доля обращений, которые возвращаются. Если закрывать сразу, эта доля исчезает из виду вместе с проблемой, которая её порождает.
Инцидент и что с ним путают
Четыре понятия, которые в разговоре путают чаще всего, а в системе учёта смешивать нельзя: у них разные цели, разные сроки и разные метрики.
| Понятие | Чем отличается | Что с ним делают |
|---|---|---|
| Инцидент | Услуга не работает или работает хуже договорённого | Восстановить работу как можно быстрее |
| Проблема | Причина одного или нескольких инцидентов | Поиск и устранение причины, времени это занимает больше |
| Запрос на обслуживаниеЗапрос на обслуживаниеШтатное обращение пользователя: доступ, оборудование, консультация. Сбоя здесь нет.ITIL 4, практическое руководство по управлению запросами на обслуживание (Service Request Management) | Штатное обращение: доступ, оборудование, консультация | Выполнить по каталогу услуг, сбоя здесь нет |
| Событие | Изменение состояния систем, замеченное мониторингом | Само по себе не инцидент; инцидентом становится по правилу |
Следствие одно, и оно тяжёлое. Если запросы на обслуживание лежат в одной очереди с инцидентами, метрики портятся у обоих потоков сразу. Среднее время закрытия смешивает пятиминутную выдачу доступа и трёхчасовое восстановление базы данных, а доля просроченного растёт из-за того, что заявку на новый монитор никто не считал срочной.
Как отделить запрос от инцидента на первой линии
Работающий признак — вопрос «работало ли это раньше так, как договорились».
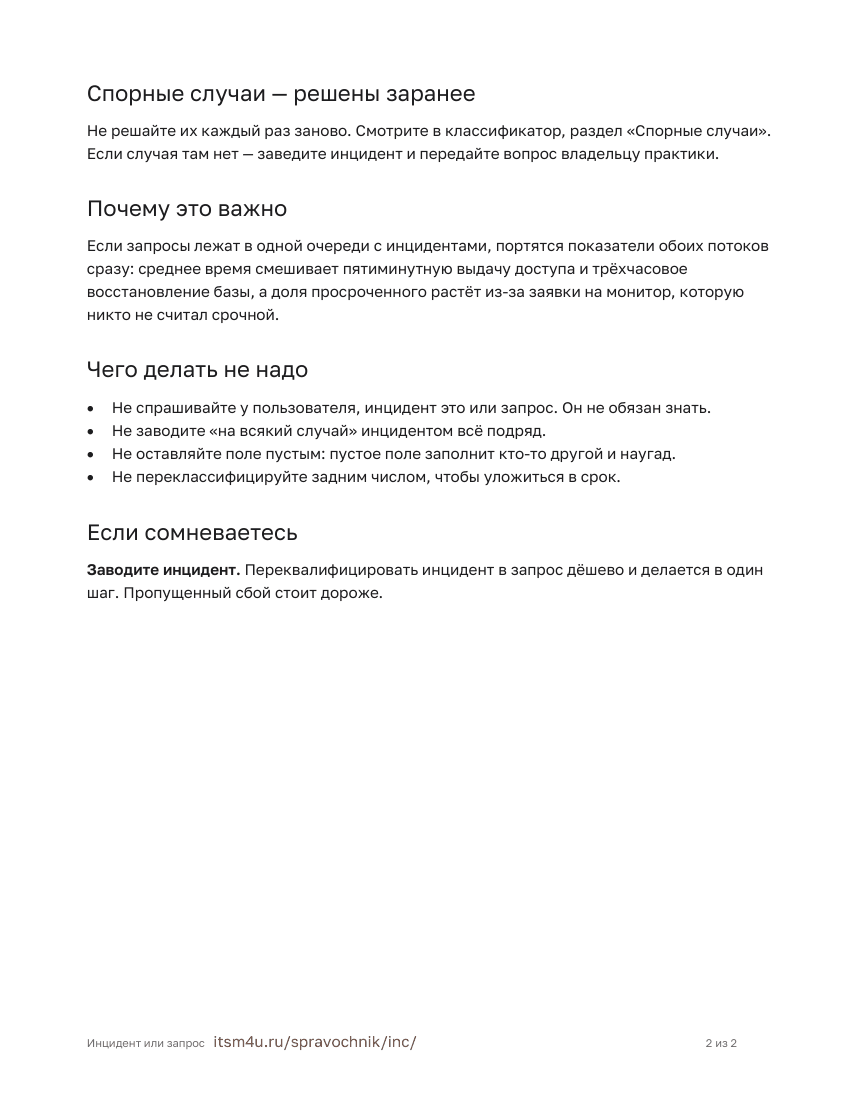
Не работает то, что должно работать, — инцидент. Нужно то, чего раньше не было или что положено по каталогу, — запрос. Пользователь почти всегда формулирует одинаково: «у меня не работает». Отделяет одно от другого именно специалист поддержки на этапе регистрации, и это единственный момент, когда это дёшево сделать.
Спорные случаи стоит закрепить решением заранее и записать в модель, а не решать заново каждый раз. Классические спорные: закончилось место на диске, истёк срок действия пароля, оборудование работает, но медленно.
Классификация и приоритет
Классификация — её же называют категоризацией — отвечает на три вопроса: какая ИТ-услуга затронута, кто отвечает за её восстановление и встречалось ли такое раньше. Последнее важнее всего: именно на этом шаге находится готовое решение, и инцидент закрывается без диагностики.
Приоритет — не то же самое, что оценка влияния. Оценка влияния и срочности — исходные данные. Приоритизация нужна только там, где ресурсов на все задачи не хватает, и делается она в контексте всей очереди команды, куда попадает и плановая работа 1.
Почему матрица «влияние × срочность» ломается
Матрица даёт клетку, а клетка — не приоритет. Как только у команды окажутся два инцидента в одной клетке, решать всё равно придётся человеку. И решать он будет по тому, чего в матрице нет: свободен ли нужный инженер, сколько времени съест каждый случай, не просрочен ли уже один из них.
Отсюда правило: матрица годится как вход, но приоритет присваивается в очереди и пересматривается по мере того, как появляются данные. Вместо формулы ITIL 4 советует два простых средства: сделать очередь видимой — доской вроде канбана — и ограничить число задач, взятых в работу одновременно 1. Видимая очередь снимает половину спора: когда все задачи команды лежат на одной доске, вопрос «что важнее» решается при всех и за минуту. Оценка влияния может измениться в середине работы — например, когда выяснится, что затронут не один отдел, а вся смена.
Ломает матрицу и другое — срочность, назначаемая пользователем. Если поле заполняет заявитель, через месяц все заявки станут срочными. Срочность оценивает тот, кто отвечает за услугу, а не тот, кто пострадал.
Линии поддержки
Классическая схема ИТ-поддержки: первая линия принимает и решает типовое, вторая разбирается в конкретной системе, третья — это разработчики системы или её поставщик. Схема рабочая, но у неё есть два условия, без которых она даёт обратный эффект.
Первая линия должна что-то решать. Если она только маршрутизирует, каждая передача добавляет время и теряет данные, а её показатель «доля решённых первой линией» просто фиксирует, насколько бесполезно это звено.
Передача должна быть с владельцем, а не в пустоту. Инцидент, переданный на вторую линию, не перестаёт быть чьим-то: владелец либо переходит, либо остаётся у первой линии, которая продолжает отвечать перед пользователем 1.
Когда линий лучше не заводить
В небольшой компании, где поддержкой занимаются два-три человека, разделение на линии добавляет бюрократию и ничего не ускоряет. Полезнее выделить не линии, а роли на смену: кто сегодня принимает обращения, кто дежурит по инцидентам, кто занят плановой работой и не отвлекается.
Здесь лучше ступеней работает сворминг — о нём ниже, в разделе про участников: под конкретный случай собирают тех, кто нужен именно в нём 1. Кого именно — определяет характер сбоя, а не оргструктура.
ITIL 4 смотрит на ступени прохладнее, чем принято думать. Их заводили ради дешевизны — решать как можно ниже по уровням, — но граница между уровнями мешает людям разговаривать и обмениваться данными, и решение от этого растягивается. Гибкие методы и системы, которые чинят себя сами, тянут в другую сторону: вместо передачи с первой линии на вторую — работа в паре, вместо череды переназначений на третьей — совместная работа нескольких команд 1.
Сроки и эскалация
Сроки восстановления берутся из двух разных мест. Обещанные потребителю — из соглашения об уровне услуг (SLA), за него отвечает SLMУправление уровнем услуг. Внутренние, по которым живёт сама команда, — из технической спецификации услуги. Восстанавливать приходится и тогда, когда отклонение потребителю не видно вовсе: нормальное состояние ИТ-инфраструктуры описано в конфигурации, которую ведёт CFGУправление конфигурациями, а не только в договоре 1.
Сроков в договорённости обычно два, и путать их нельзя. Срок реакции — за сколько инцидентом займутся, срок восстановления — за сколько вернут работу. Заказчику важен второй. А выполняется легче первый, поэтому отчёт по срокам бывает зелёным при неработающей ИТ-услуге. Меряют их порознь, обе метрики — в таблице ниже. Числа берут из своей договорённости, но порядок величин у Брукса такой. Время между передачей заявки на вторую линию и её принятием он считает опасным начиная с десяти минут. На саму реакцию приводит пример по трём приоритетам: десять минут для высшего, тридцать для среднего, до двух часов для низшего 13. Это пример, а не норма: приоритетов у вас может быть не три, и стоить они будут других сроков.
Эскалаций две, и это разные действия. Техническая — привлечь тех, у кого больше компетенции; управленческая — сообщить руководителю, что срок под угрозой. Первая ускоряет решение. Вторая не ускоряет ничего, зато бизнес узнаёт о срыве срока вовремя. Регламент, где есть только вторая, превращает эскалацию в наказание, и инженеры перестают её запускать.
Кто участвует
Специалист первой линии принимает сигнал, регистрирует и классифицирует инцидент, а после восстановления закрывает запись. Его главная ответственность не «быстро принять звонок», а качество данных в записи: от него зависят и правильность решений, и скорость восстановления, и возможность потом найти причину 1.
Инженер ответственной команды диагностирует и восстанавливает. Работает не в одиночку: при сложных инцидентах применяется сворминг — совместная работа над одним случаем, куда собирают не много людей, а нужных 1. Встречаться лично для этого не обязательно.
Менеджер инцидентов отвечает не за отдельный сбой, а за то, как практика работает в целом. Он согласует работу команд и следит, чтобы в организации знали о происходящем. Он же проводит периодические разборы и по их итогам меняет модели и процедуры 1. Отдельной должности может и не быть: ITIL 4 прямо допускает, что эти обязанности берёт на себя владелец услуги, продукта или того элемента инфраструктуры, с которым связан инцидент 1.
Координатор критичного инцидента — те же обязанности, но только на критичных случаях; полномочий у этой роли больше, и под неё выделяют отдельные ресурсы 1. Координатор не чинит — он держит картину целиком, распределяет работу и разговаривает с бизнесом и пользователями, освобождая инженеров от объяснений.
Владелец ИТ-услуги — в некоторых компаниях его называют сервис-менеджером — участвует в разборе после инцидента и решает, что менять в самой услуге.
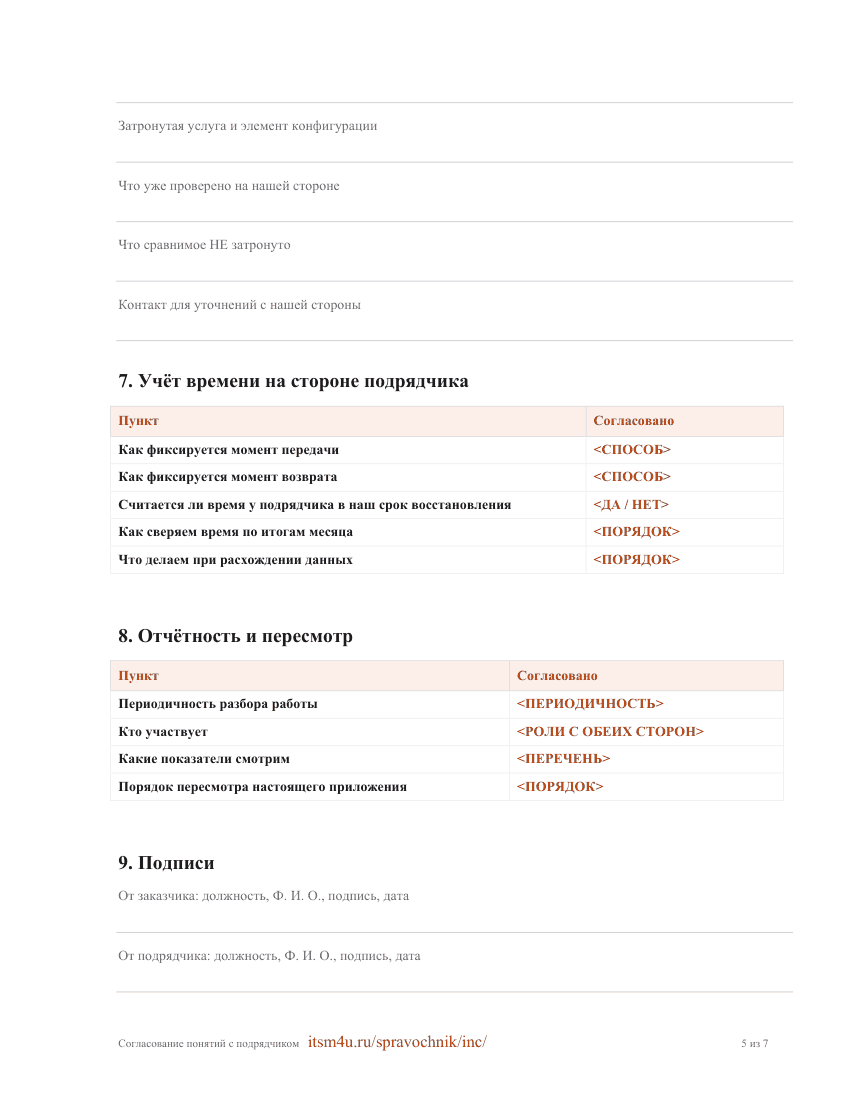
Поставщики и подрядчики участвуют наравне с внутренними командами, если услуга опирается на них. В модели инцидента их участие описывают отдельно: кого привлекаем и как, за какой срок подрядчик обязан взяться за работу и с какого момента инцидент считается переданным ему 1. Без этого время у подрядчика не измеряется и списывается на «ждём вендора» — самую удобную формулировку в отчёте.
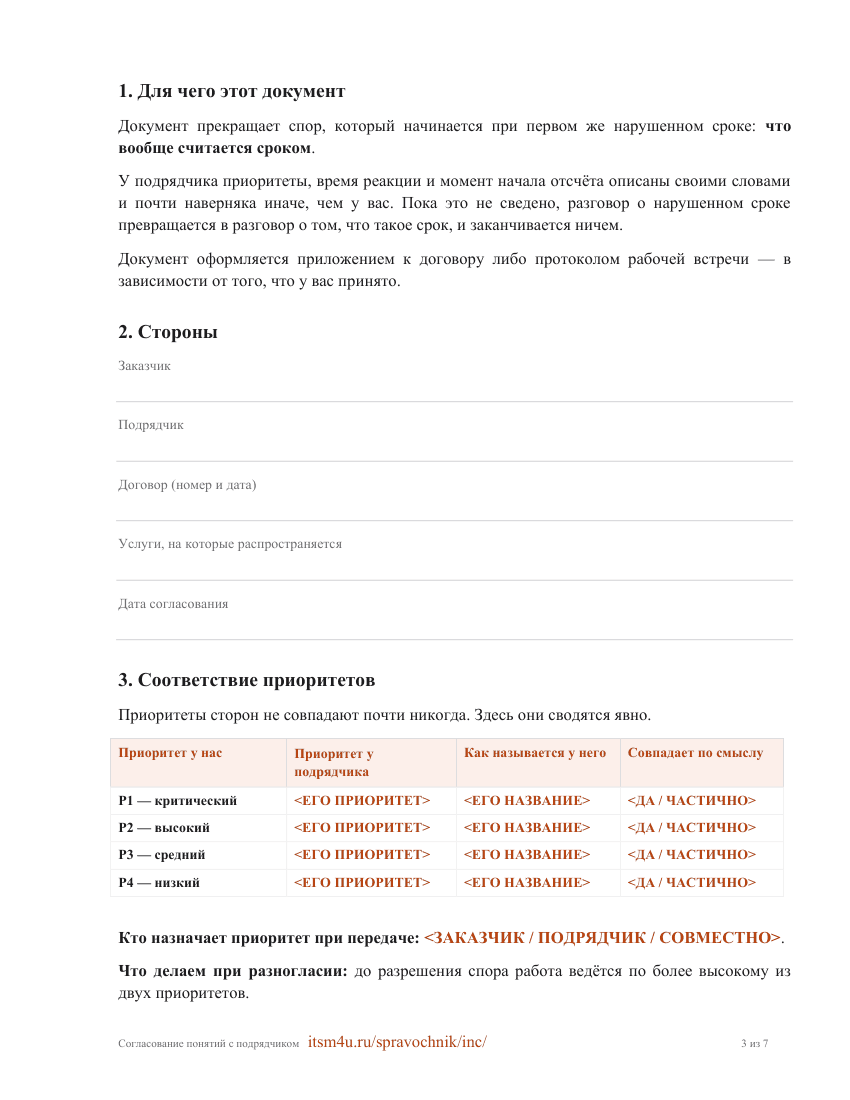
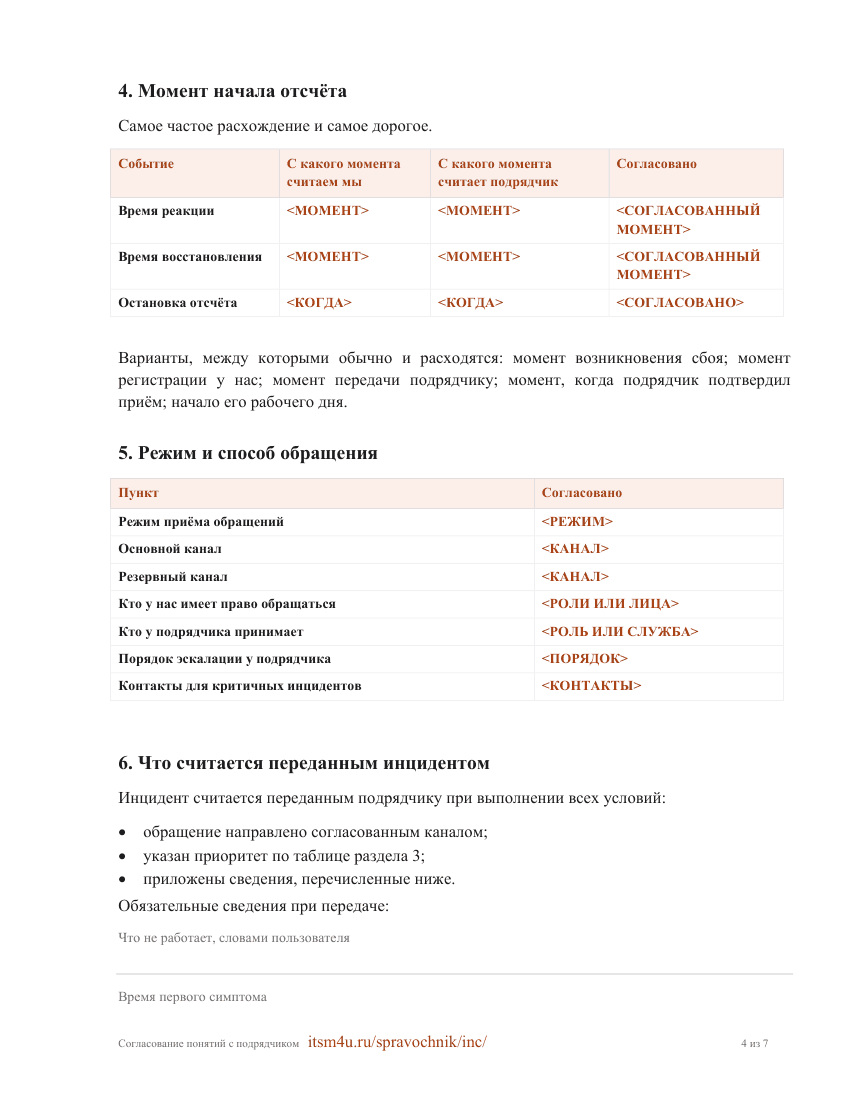
Отдельная работа — договориться об одинаковых понятиях с поставщиком. Приоритет, срок реакции и момент, с которого он считается, у него описаны своими словами и почти наверняка иначе, чем у вас. Пока это не сведено, разговор о нарушенном сроке превращается в спор о том, что такое срок.
Про культуру
Устройство процесса задаёт, что люди могут делать; культура ИТ-службы задаёт, что они делают на самом деле. ITIL 4 описывает три беды, которые повторяются из компании в компанию. Инцидент перебрасывают между командами. Инженер чувствует, что заблокирован другими и сам ни за что не отвечает. В почёте герой, который вытащил всех из аварии один 1. Регламентом это не лечится. Ниже три черты культуры, без которых практика не работает даже при идеальном регламенте 1.
Ответственность общая, а не персональная. Инцидент — это отказ системы, а не вина конкретного инженера. Как только за инцидент начинают спрашивать с человека, данные в записях портятся первыми: формулировки становятся обтекаемыми, время в записи подгоняют под удобную версию, а часть инцидентов просто не регистрируют.
Разбор без поиска виноватого. Вопрос разбора — «что позволило этому случиться и остаться незамеченным», а не «кто нажал». Разбор с поиском виноватого даёт неполные данные, а на неполных данных не построить ни одного улучшения.
Учиться на том, что уже случилось. Каждый инцидент — это уже оплаченный факт о том, как система ведёт себя на самом деле: за него заплатили простоем. Организация, которая закрывает заявку и идёт дальше, платит и не забирает покупку.
Что спрашивают на разборе
Вопросы разбора удобнее выводить не из шаблона, а из того, что практика и так меряет. Тогда каждый ответ либо подтверждает один из трёх признаков работающей практики, либо показывает, где он не выполняется.
Как узнали? Мониторинг или человек, и можно ли было заметить раньше. Это первый признак практики, и с него же начинается таблица метрик.
Что видно по записи? Диагностика записывалась по ходу дела или восстанавливалась по памяти после. Запись, собранная задним числом, делает остальные вопросы разбора безответными.
Где инцидент лежал, а не решался? Сколько времени ушло на ожидание и чего именно ждали. Основная потеря чаще здесь, а не в сложности самой поломки.
Кто был владельцем в каждый момент? По истории назначений видно, передавали инцидент с названной причиной или сбрасывали.
Чем решили? Готовым решением, моделью или изобрели заново. Если заново — почему этого не было в базе знаний и появилось ли теперь.
Что осталось после? Обходной путь, причина которого не передана дальше, — это отложенный инцидент, а не закрытый.
Что меняем? Один конкретный пункт: правило мониторинга, модель инцидента, поле в записи или порядок эскалации. Именно он и отличает разбор от протокола — почему, сказано выше, в разделе про то, когда практика работает.
Что должно быть в записи
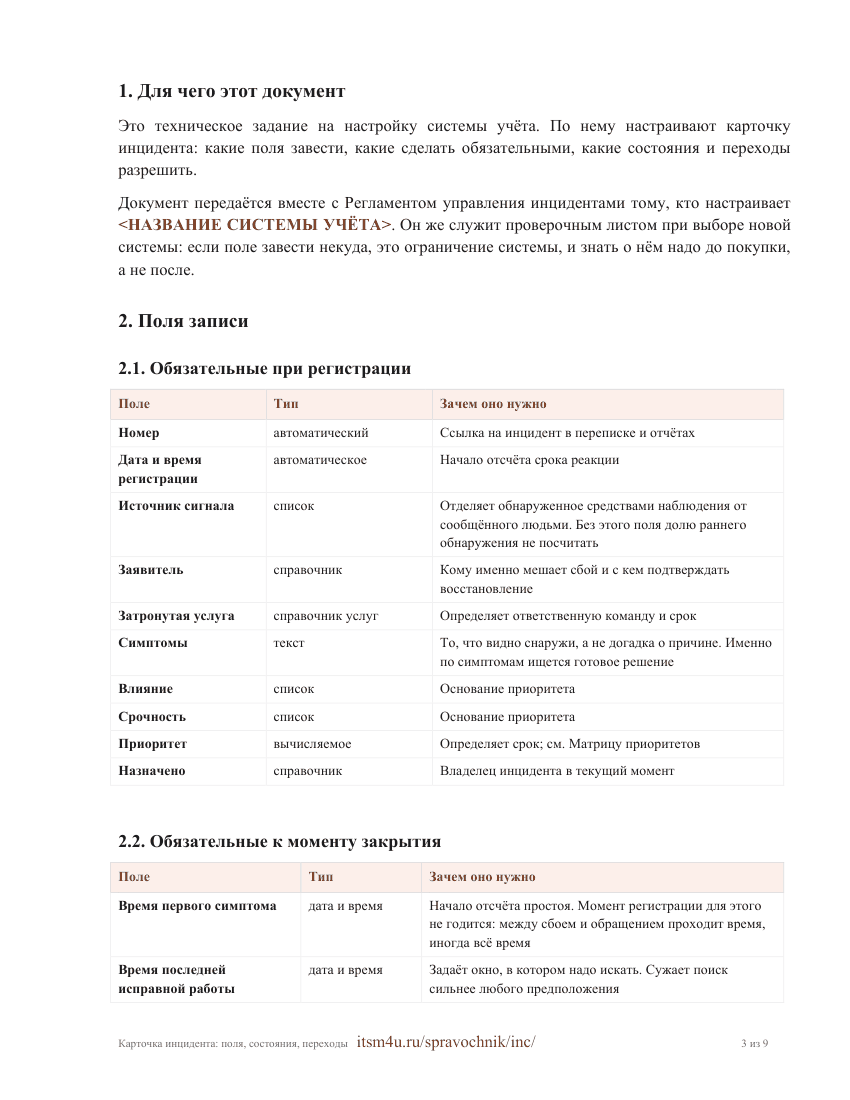
Запись об инциденте — не отчётность для руководителя ИТ, а рабочий инструмент: по ней ищут готовое решение, ею сужают круг поиска и на ней потом держится всё, что вообще можно посчитать. Поэтому ниже не просто перечень полей, а объяснение, зачем нужно каждое 1.
Поля записи об инциденте и зачем каждое
| Поле | Зачем оно нужно |
|---|---|
| Короткое название | Какая функция или процесс и что с ней не так. По внятному названию готовое решение находится быстрее, чем по любому другому полю |
| Откуда пришёл сигнал | Отделяет обнаруженное мониторингом от сообщённого людьми. Без этого поля долю раннего обнаружения не посчитать |
| Затронутый элемент | Связывает инцидент с конфигурацией: по нему находятся прошлые инциденты того же элемента и открытые изменения по нему |
| Симптомы | То, что видно снаружи, а не догадка о причине. Именно по симптомам ищется готовое решение |
| Время первого симптома | Начало отсчёта простоя. Момент регистрации для этого не годится: между сбоем и обращением проходит время, и иногда всё время |
| Время последней исправной работы | Задаёт окно, в котором надо искать. Сужает поиск сильнее, чем любая гипотеза |
| Применялось ли автоматическое восстановление | Показывает, сработала ли автоматика и что именно она успела изменить до прихода человека |
| Размещение | Площадка, регион, сегмент. Отвечает на вопрос, локальный это сбой или общий |
| Характер и масштаб влияния | Кто и в какой мере не может работать сейчас. Основание для приоритета и для решения, звать ли координатора |
| Что будет, если не чинить | Влияние сейчас и влияние потом — разные величины, и в источнике это два разных поля. Второе объясняет, зачем спешить, когда прямо сейчас страдает один отдел |
| Что сравнимое НЕ затронуто | Самое недооценённое поле. Соседний узел работает, соседний офис работает, вчерашняя версия работает — и круг поиска сужается за один шаг |
| Ход диагностики | Что проверили, что предположили, что получилось. Пишется по ходу, иначе не пишется вовсе |
| Кому назначено сейчас | Владелец в каждый момент времени. По истории этого поля видно, инцидент передавали или бросали |
Про «что не затронуто» стоит сказать отдельно. Оно превращает диагностику из перебора гипотез в сравнение двух состояний, а сравнивать быстрее, чем угадывать.
Практике нужны и данные, которых в самой записи нет: перечень ИТ-услуг и их потребителей, устройство услуг и связи между элементами инфраструктуры, договорённости о сроках, накопленная история прошлых инцидентов и удовлетворённость тех, кого сбой задел 1. Они живут в CFGУправление конфигурациями, SLMУправление уровнем услуг и KNWУправление знаниями — и качество разбора зависит от них не меньше, чем от аккуратности специалиста на входе.
Чем автоматизируется
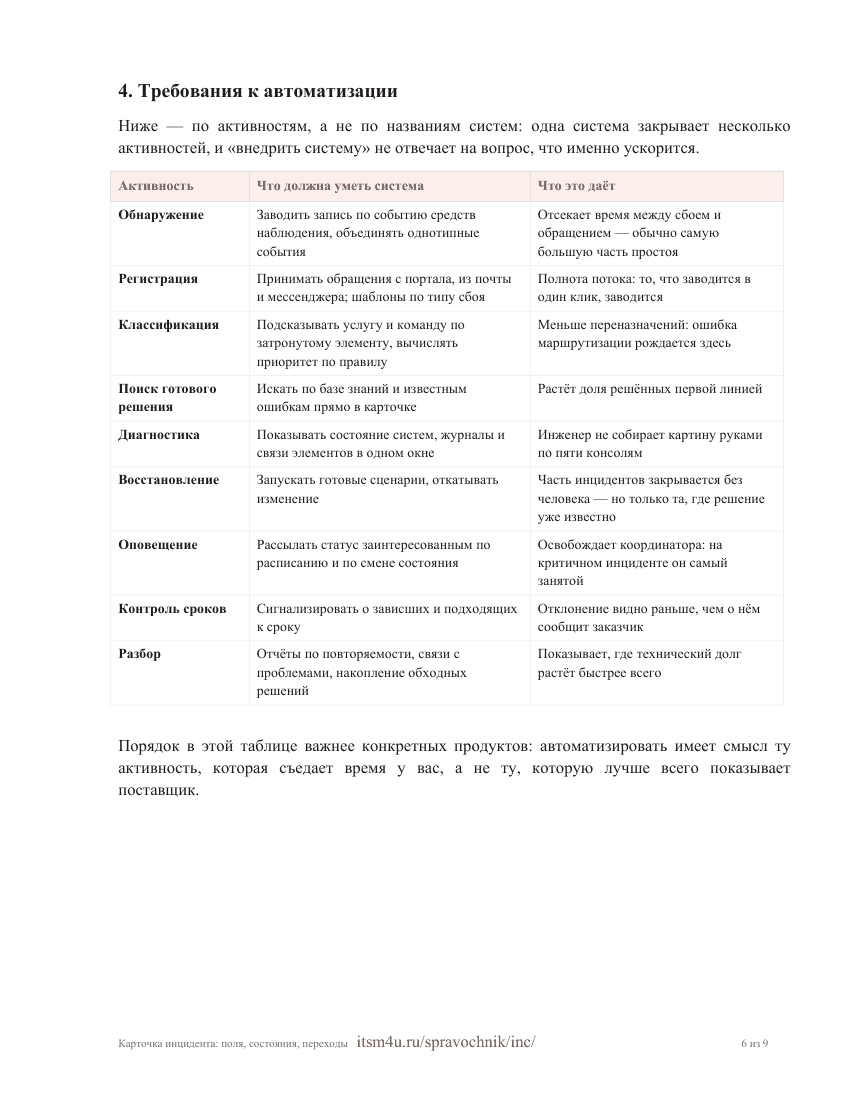
Система управления инцидентами — это программа, в которой живут записи: туда сбой попадает, там его ведут, оттуда берут отчёты. Выбирать её по длине списка возможностей бесполезно, потому что список у всех длинный. Полезнее разбирать по активностям: одна программа закрывает сразу несколько активностей, и «внедрить ITSM-платформу» — это не ответ на вопрос, что именно ускорится 1.
| Активность | Чем автоматизируется | Что это даёт |
|---|---|---|
| Обнаружение | Мониторинг, правила корреляции, автоматическое заведение записи по событию | Отсекает время между сбоем и обращением — обычно самую большую часть простоя |
| Регистрация | Портал самообслуживания, приём из почты и мессенджера, шаблоны по типу сбоя | Полнота потока: то, что заводится в один клик, заводится |
| Классификация | Подсказка услуги и команды по затронутому элементу, автоприоритет по правилу, чтение текста обращения языковой моделью | Меньше переназначений, потому что ошибка маршрутизации рождается здесь. Модель ошибается тише правила: неверный маршрут выглядит уверенно и ловится только по числу переназначений |
| Поиск готового решения | Поиск по базе знаний и известным ошибкам прямо в карточке | Растёт доля решённых первой линией без передачи дальше |
| Диагностика | Сбор состояния ИТ-систем, журналы и связи элементов инфраструктуры в одном окне | Инженер не собирает картину руками по пяти консолям |
| Восстановление | Готовые сценарии перезапуска, откат релиза, автоматическое исправление по правилу | Часть инцидентов закрывается без человека — но только та, где решение уже известно |
| Оповещение | Автоматический статус для бизнеса и пользователей по расписанию и по смене состояния | Освобождает координатора от объяснений, а он на критичном инциденте самый занятой |
| Контроль сроков | Сигнал о зависших и подходящих к сроку | Отклонение видно раньше, чем о нём сообщит заказчик |
| Разбор и улучшение | Анализ повторяемости, связи с проблемами, накопление обходных путей | Показывает, где технический долг растёт быстрее всего |
Порядок в этой таблице важнее конкретных продуктов: автоматизировать имеет смысл ту активность, которая у вас съедает время, а не ту, которую лучше всего продаёт поставщик. Эта же раскладка — рабочий способ сравнивать системы между собой: не по длине списка возможностей, а по тому, какие активности автоматизация закрывает, а какие остаются на человеке.
Чем автоматизируют на практике. Ниже — решения, которые встречались в разобранных нами внедрениях этой практики. Это не рекомендация и не рейтинг: продукт попал сюда потому, что его назвали в проекте с проверяемым источником.
Заказное решение на BMC Remedy
Платформа ITSM1 проект в нашем каталогеПорядок не рейтинг: сверху недавно добавленные, дальше те, что чаще встречаются в разобранных нами внедрениях, а при равном числе — те, чьё внедрение свежее. Весь список с фильтрами по практике и происхождению — в каталоге решений.
Как измерять
Метрики практики группируются вокруг трёх факторов успехаФактор успеха практикиТо, что должно быть верно, чтобы практика выполняла своё назначение.ITIL Service Operation, раздел 4.2.8: рано обнаруживать, быстро решать, постоянно улучшать подходы 1. Третья редакция раскладывала их подробнее — шесть факторов и восемнадцать показателей под ними — и советовала смотреть каждый показатель в семи разрезах: по категории, сроку, влиянию, срочности, затронутой услуге, размещению и приоритету, сравнивая с прошлым периодом 12.
| Что меряем | Зачем | Чем искажается |
|---|---|---|
| Время между возникновением и обнаружением (MTTD) | Показывает, работает ли мониторинг на самом деле | Не считается вовсе, если момент возникновения не фиксируется |
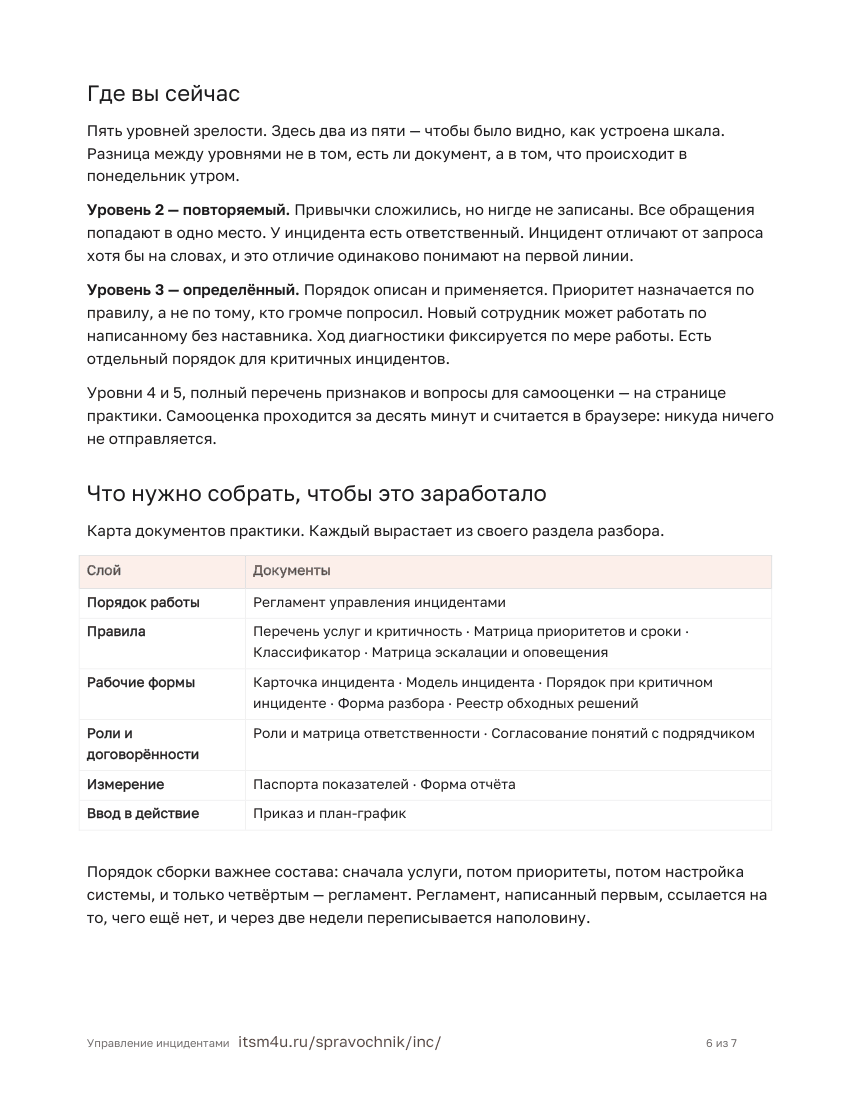
| Доля инцидентов, обнаруженных мониторингом | Отделяет зрелую эксплуатацию от реактивной | Растёт от шумных срабатываний, которые инцидентами не являются |
| Среднее время до первого отклика (MTTA) | Сколько инцидент ждёт, пока им вообще займутся | Гонка за откликом рождает «принято в работу» без работы: статус меняют, чтобы остановить таймер |
| Среднее время восстановления (MTRS, он же MTTR) | Главный показатель скорости: сколько в среднем услуга не работает | Среднее прячет хвост: несколько многочасовых инцидентов растворяются в массе коротких, и по нему не видно как раз тех случаев, ради которых практику и заводили |
| Доля решённых в срок | Выполнение договорённостей об уровне услуг | Зависит от того, какой срок имеется в виду: у реакции и у восстановления они разные, и отчёт по первому ничего не говорит про второй |
| Незакрытый остаток и его возраст | Справляется ли команда с потоком, а не только быстро ли закрывает | Растёт и от роста потока, и от падения скорости — по одному числу причину не отличить |
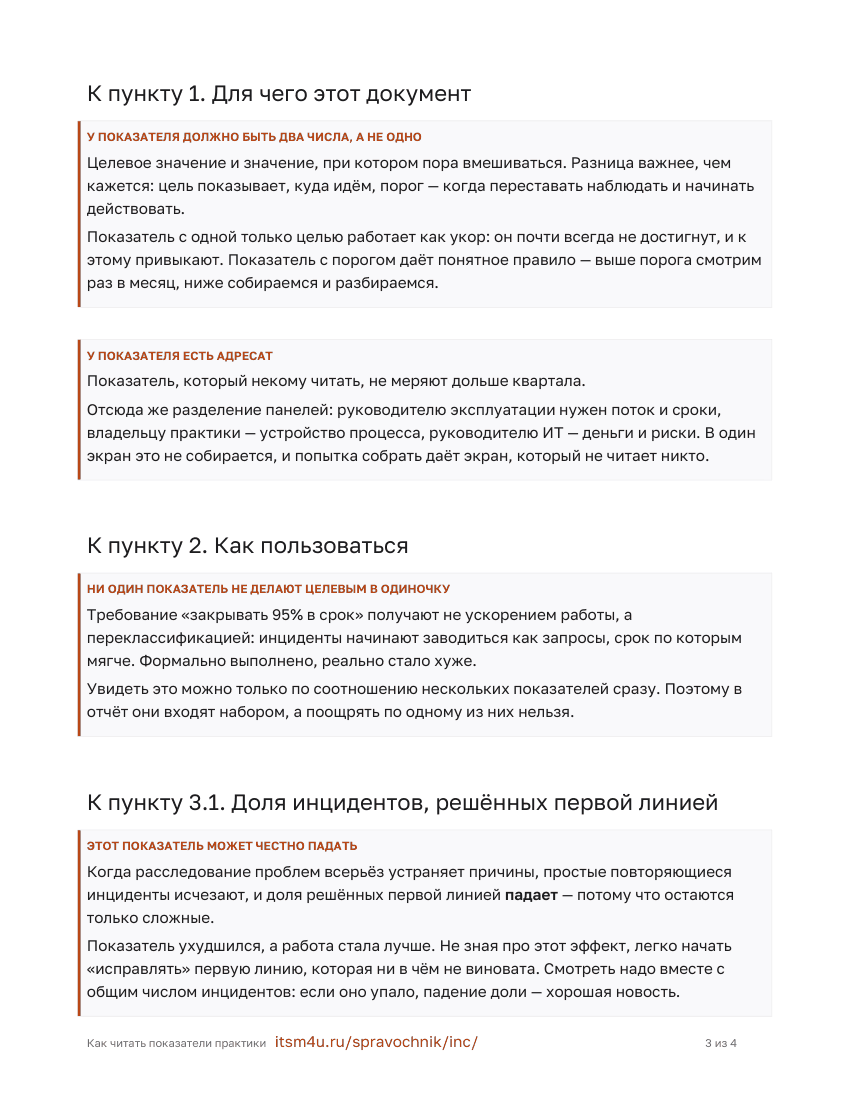
| Доля решённых первой линией (FLR) | Качество классификации и базы знаний | Улучшается закрытием сложных случаев «по истечении времени» |
| Число переназначений | Прямо показывает, где ломается маршрутизация | — |
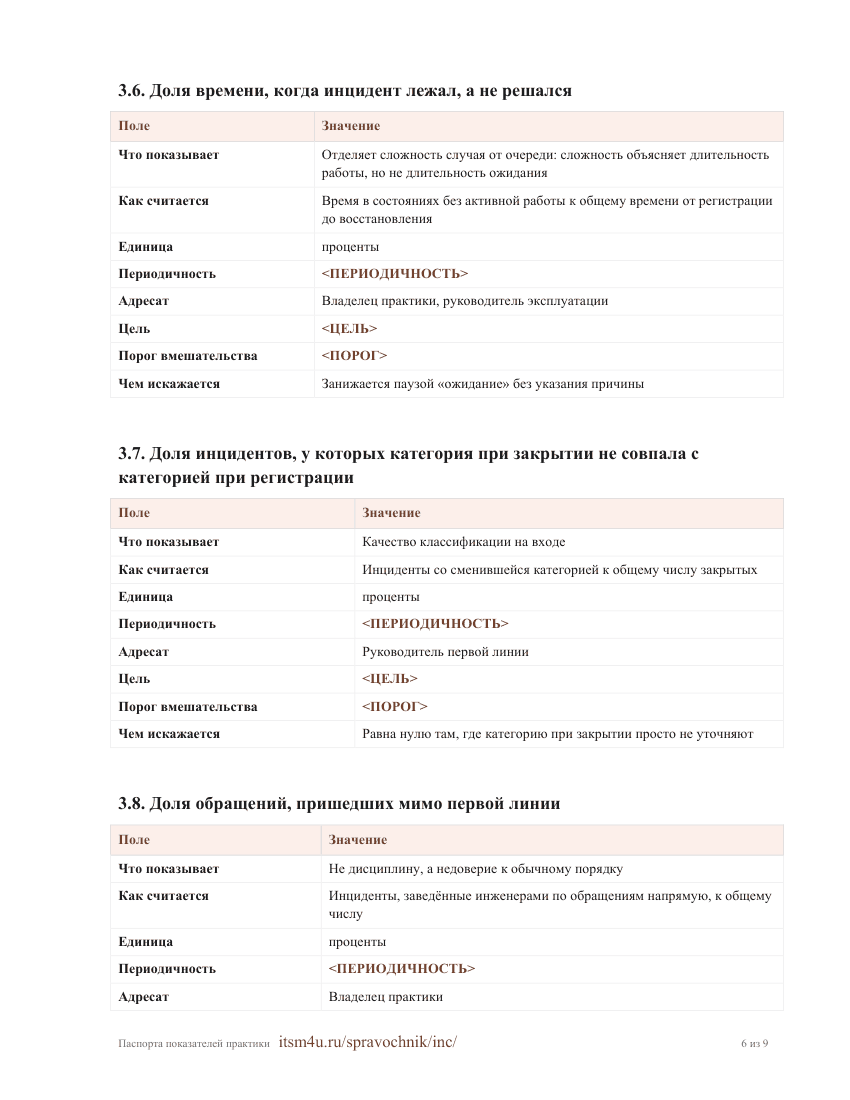
| Доля времени, когда инцидент лежал, а не решался | Отделяет сложность случая от очереди: сложность объясняет длительность работы, но не длительность ожидания | Занижается тем же приёмом, что и метрика срока, — паузой «ожидание» без указания причины |
| Доля решённых по ранее записанным решениям | Работает ли база знаний | — |
| Доля инцидентов, закрытых без участия человека | Какую часть потока система закрывает сама 1 | Растёт от перевода простых сценариев на автоматику, а не от того, что система стала умнее |
| Доля инцидентов, у которых категория при закрытии не совпала с категорией при регистрации | Прямо показывает качество классификации на входе 13 | Равна нулю там, где категорию при закрытии просто не уточняют |
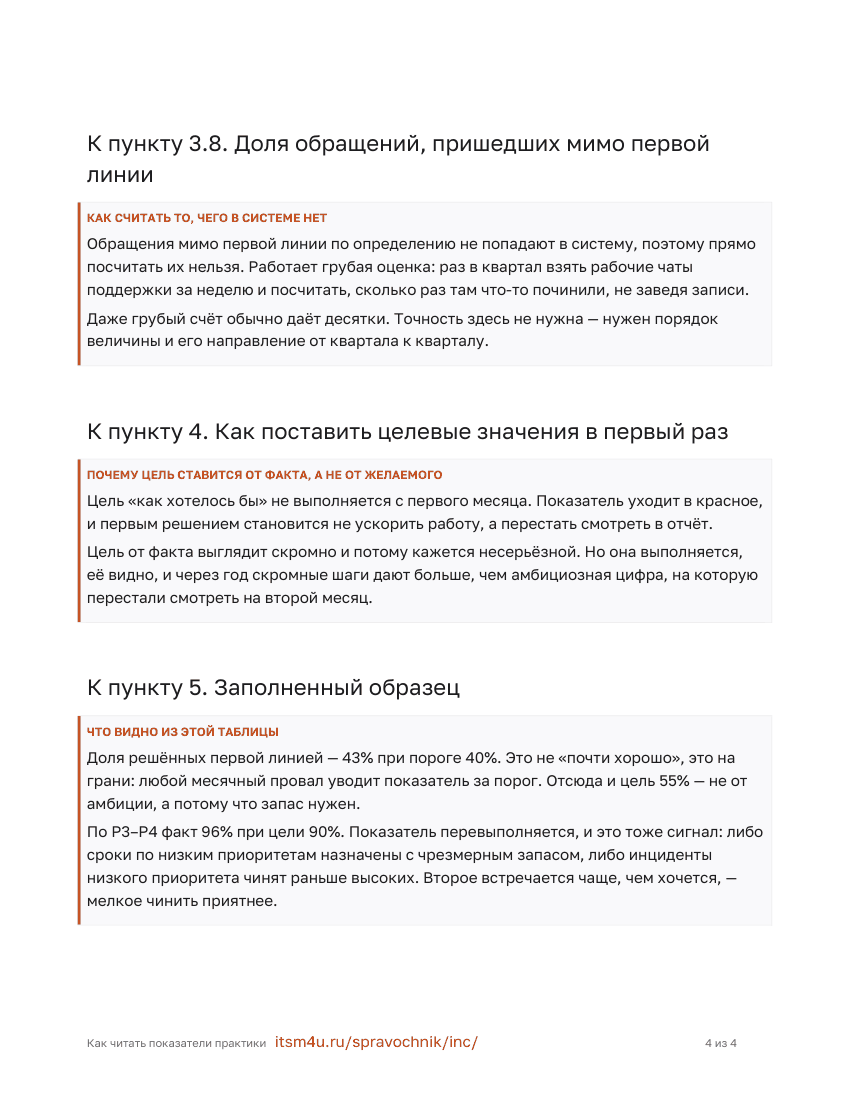
| Доля обращений, пришедших к инженерам мимо первой линии | Показывает не дисциплину, а недоверие к обычному порядку 13 | Не считается, если такие обращения вообще не заводятся |
| Доля обращений, вернувшихся после закрытия | Закрыли по факту или со слов инженера | Равна нулю там, где повторное обращение заводят новой записью |
| Удовлетворённость тех, кого сбой задел (CSAT) | Противовес всем остальным: при слишком быстром закрытии остальные метрики растут, а эта падает 13 | Портится частыми опросами — люди перестают отвечать |
Про среднее время спорят не о формуле, а о границах. С какого события считать — с возникновения сбоя, с обращения пользователя или с момента регистрации; чем заканчивать отсчёт — восстановлением работы или закрытием заявки. Пока это не записано, две команды считают «одно и то же» и получают числа, различающиеся вдвое. Про закрывающую границу — ниже, в правиле про «решён» и «закрыт».
Метрики, которых здесь нет, и почему
Наработка на отказ (MTBF) и время до отказа (MTTF). Их часто ищут в этом списке, но они измеряют надёжность самого оборудования или системы, а не работу практики. Живут они в AVLУправление доступностью: там по ним планируют резервирование и договариваются о доступности. Управление инцидентами на промежутки между отказами не влияет — оно влияет на то, сколько длится каждый отказ.
Стоимость одной заявки. Показатель финансовый, а не процессный: он меняется от способа учёта рабочего времени сильнее, чем от того, как обрабатываются инциденты.
Доля критичных инцидентов. Считается легко, читается плохо: её задаёт тот, кто присваивает признак критичности. Рост доли одинаково означает и что услуга стала хуже, и что признак наконец начали ставить честно.
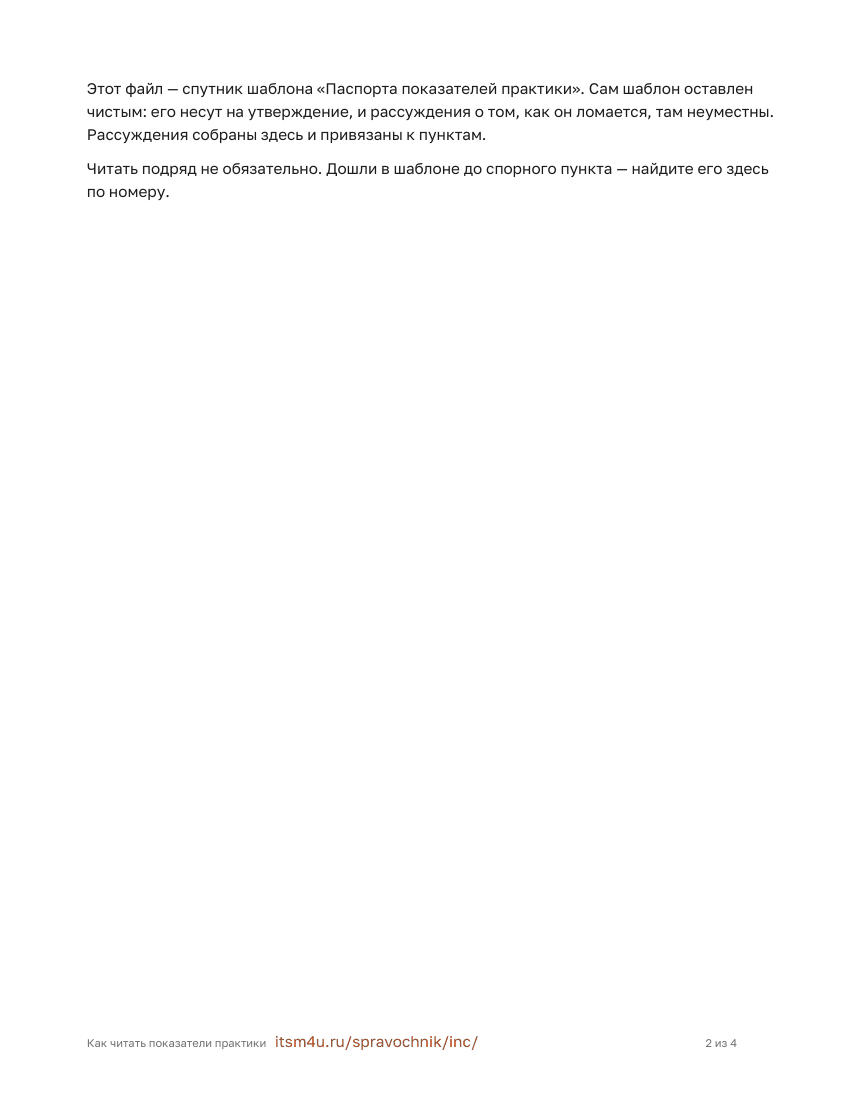
У метрики должны быть два числа, а не одно. Целевое значение и значение, при котором пора вмешиваться. Разница важнее, чем кажется: цель показывает, куда идём, порог — когда переставать наблюдать и начинать действовать. Брукс задаёт оба числа у каждой метрики 13:
- решено первой линией — цель 85%, опасный порог ниже 65%;
- решено правильно с первого раза — цель 90%, порог ниже 75%;
- инцидент ушёл не в ту команду — цель 20%, порог 30%;
- решено в срок по приоритету — цель 95%, порог ниже 90%;
- решено до того, как пользователь сообщил, — цель 15%, опасный порог 0%;
- классифицировано неправильно — цель 40%, порог 60%.
Последняя пара показывает, до чего эти числа неочевидны. Брукс считает нормой, что четыре инцидента из десяти классифицированы неверно, а тревогой — шесть. Сами числа к вам не переносятся: они зависят от услуги. Переносится другое — привычка держать у показателя обе границы, а не одну. А в строке про закрытые до обращения — редкий случай, когда опасным значением стоит ноль. Пока таких инцидентов нет ни одного, раннего обнаружения нет вовсе, сколько бы средств мониторинга ни было куплено.
У метрики есть адресат. Показатель, который некому читать, не меряют дольше квартала. Полезно записывать рядом с метрикой, кому она адресована: владельцу практики, руководителю ИТ, заказчику или самой команде 13. Отсюда же растёт разделение панелей: руководителю эксплуатации нужен поток и сроки, менеджеру практики — устройство процесса, и в один экран это не собирается.
Улучшение соседней практики может испортить вашу метрику. Пример из книги: когда управление проблемами всерьёз устраняет причины, простые повторяющиеся инциденты исчезают, и доля решённых первой линией падает — потому что остаются только сложные 13. Метрика ухудшилась, а работа стала лучше. Не зная про этот эффект, легко начать «исправлять» первую линию, которая ни в чём не виновата.
Решён и закрыт — разные моменты. Время решения считается до восстановления работы, а не до закрытия заявки: между ними лежит административный шаг, который заказчику неинтересен, и включать его в метрику значит мерить свою бюрократию вместо скорости восстановления 13. Это требование к системе: она обязана различать два состояния — у нас они разведены в жизненном цикле.
Вот как этот набор выглядит, собранный в панель. Смысл не в перечне показателей, а в сравнении: само по себе число не значит почти ничего — значение имеет направление и расстояние до порога.

Панель менеджера практики: где процесс теряет время и на чём ошибается. У каждого показателя — цель и порог вмешательства. Нажмите, чтобы открыть целиком.

Панель руководителя эксплуатации — поток, сроки, люди и деньги. Метрики не совпадают с верхней ни в одной позиции, и это не упущение: вопросы разные. Ещё пять ролей разобраны на странице панелей.
Ни одну из них нельзя делать целевой в одиночку. Требование «закрывать 95% в срок» получают не ускорением работы, а переклассификацией: инциденты начинают заводиться как запросы, срок по которым мягче. Формально метрика выполнена, реально стало хуже, и увидеть это можно только по соотношению нескольких показателей сразу.
Зрелость управления инцидентами
Управление инцидентами бывает на разных уровнях зрелости, и разница между ними не в том, есть ли документ, а в том, что происходит в понедельник утром. Ниже наблюдаемые признаки: по каждому видно, выполняется он у вас или нет, без толкований.
Первый уровень не описан намеренно: на нём нет требований, он означает их отсутствие.
Уровень 2ПовторяемыйПривычки сложились, но нигде не записаны.
- Все обращения попадают в одно место, а не расходятся по почте, чатам и личным сообщениям
- У инцидента есть ответственный: по записи видно, кто им сейчас занимается
- Инцидент отличают от запроса на обслуживание хотя бы на словах, и это отличие одинаково понимают на первой линии
Уровень 3ОпределённыйПорядок описан и применяется.
- Приоритет назначается по правилу, а не по тому, кто громче попросил
- Порядок работы с инцидентом описан, и новый сотрудник может по нему работать без наставника
- Ход диагностики фиксируется в записи по ходу дела, а не восстанавливается по памяти после закрытия
- Есть отдельный порядок для критичных инцидентов, и он отличается от обычного
Уровень 4УправляемыйПрактика измеряется и держится в норме.
- Заявлено время реакции и восстановления, и выполнение этого срока измеряется
- Известна доля инцидентов, решённых первой линией без передачи дальше
- Отклонения видны до того, как о них сообщит заказчик: есть сигнал о зависших и просроченных
- Повторяющиеся инциденты передаются в управление проблемами, и это происходит регулярно, а не в исключительных случаях
Уровень 5ОптимизируемыйПрактику осознанно улучшают на основании данных.
- Решения по изменению процесса принимаются на основании измерений, а не ощущений
- Считается стоимость инцидентов: трудозатраты и потери от простоя
- После критичных инцидентов проводится разбор, и его выводы доходят до изменений в процессе
Где ломается чаще всего
Инциденты не доходят до системы. Часть решается в мессенджерах и коридорах и в записи не попадает. Проверяется просто: возьмите рабочие чаты ИТ-поддержки за неделю и посчитайте, сколько раз там что-то починили, не заведя записи. Даже грубый счёт обычно даёт десятки — и тогда метрики надёжности показывают дисциплину регистрации, а не работу систем.
Обходные пути копятся и превращаются в технический долг. Обходное решение восстанавливает работу быстро, но откладывает устранение причины и может породить новые инциденты 1. Пока обходные пути не передаются в управление проблемами, где причину действительно устраняют, долг растёт молча — а потом даёт всплеск инцидентов, для которого не найти повода.
Долг этот измеримый, а не образный, и считается тремя числами: сколько обходных путей применяется сейчас, сколько раз каждый применён за период и сколько времени в среднем прошло с первого применения. Обходной путь, который живёт полгода и применён сорок раз, — уже не временная мера, а часть услуги, только нигде не записанная. Считать их стоит начинать раньше, чем появится чувство, что «часто ломается»: к этому моменту долг обычно уже больше, чем кажется.
Данные записываются после, а не по ходу. «Перезагрузили кластер, через сорок пять минут заработало» — это не запись, а её отсутствие: документация хода работ подменяется итогом. За такой фразой прячется последовательность действий, которую потом не восстановить, и разбор причины становится невозможен 1. К записи ITIL 4 предъявляет три требования сразу: вести её по ходу, а не после; ничего не пропускать; объяснять, зачем был сделан каждый шаг 1. Причина действия для разбора важна не меньше самого действия.
Приоритет присваивают один раз и больше не пересматривают. Признак виден в данных: у закрытых инцидентов приоритет почти всегда тот же, что поставили при регистрации. Почему клетка матрицы «влияние × срочность» — это вход в решение, а не само решение, разобрано выше, в разделе про классификацию.
Первая линия превращается в передаточное звено. Признак не в регламенте, а в числах: доля решённых первой линией не растёт годами, а переназначений на инцидент стабильно больше двух. Отчего так выходит — разобрано выше, в разделе про линии поддержки.
Заявку закрывают, не дождавшись подтверждения. Между «решён» и «закрыт» стоит подтверждение пользователя — почему это два разных состояния, разобрано выше, в жизненном цикле. Проверяется по доле обращений, которые возвращаются в первые сутки после закрытия: заметная доля означает, что закрывают со слов инженера, а сбой был устранён частично.
Как менялись стандарты
В третьей редакции ITIL управление инцидентами было процессом с предписанным порядком шагов — учебные материалы того времени так его и разбирают, шаг за шагом 7. В четвёртой это практика — набор ресурсов, который в разных потоках создания ценностиЦенностьПольза и выгода, которые сторона получает от услуги; величина субъективная.ITIL 4, книга ITIL Foundation собирается по-разному 1. Практическая разница не косметическая: раньше от организации ждали, что она внедрит процесс как описано, теперь — что соберёт под свою ситуацию из описанных элементов.
Второе изменение — приоритизация переехала в контекст команды. Раньше приоритет считался по матрице влияния и срочности и был свойством самого инцидента. Теперь это способ распределить людей между задачами, и за них инцидент конкурирует в том числе с плановой работой 1.
Третье — упор сместился на раннее автоматическое обнаружение. Регистрация со слов пользователя описана как всё ещё распространённая, но уже не как хорошая практика 1.
Четвёртая редакция не застыла: в 2023 году руководство по инцидентам пересмотрели, прибавив две главы — про оценку зрелости и рекомендации 1. А в 2026 году вышел ITIL (Version 5); какое-то время обе версии ходят параллельно, поддержка ITIL 4 заканчивается 31 декабря 2027 года 14. Эта страница опирается на ту редакцию руководства, которую я читала, — 2020 года.
Где описано
| Свод | Раздел |
|---|---|
| ITIL 4 | Отдельное практическое руководство Incident Management 1 |
| COBIT 2019 | Цель DSS02 «Управление запросами на обслуживание и инцидентами» 4 |
| ГОСТ Р ИСО/МЭК 20000-1-2021 | Пункт 8.6.1 «Управление инцидентами» 515 |
| MOF 4.0 | SMF-функция «Обслуживание заказчиков» на этапе «Эксплуатация» 2 |
Требования, а не советы, — только у стандарта. ГОСТ Р ИСО/МЭК 20000-1-2021 — русская редакция того же ISO/IEC 20000-1:2018, слово в слово. Пункт 8.6.1 требует пяти действий над инцидентом: зарегистрировать и классифицировать, расставить по приоритету с учётом воздействия и экстренности, при необходимости эскалировать, урегулировать, закрыть. Записи при этом обновляются по ходу 15.
Отдельно стандарт говорит про крупные аварии — он зовёт их значительными инцидентами. Критерии, по которым инцидент таким признают, записывают заранее. Дальше требуется документированная процедура, назначенный ответственный за каждый такой случай и осведомлённость высшего руководства, а после урегулирования — отчёт и разбор ради улучшений 15. Слово «критичный» пришло из ITIL, «значительный» — из стандарта; в регламенте стоит написать оба, иначе аудитор и инженер будут говорить о разном.
MOF описывает ту же работу под другим именем и с другой разбивкой: у него управление инцидентами не отдельная практика, а часть функции обслуживания заказчиков, живущей на этапе эксплуатации 23. Расхождение содержательное: MOF сильнее связывает поддержку пользователей с эксплуатацией инфраструктуры, тогда как ITIL разводит их по разным практикам. Оба документа выложены у нас: лицензия Microsoft это разрешает.
69Своды знаний и стандарты — разобраны отдельноЧем ITIL отличается от COBIT и ISO, что из этого обязательно, а что на выбор, и где брать первоисточник. У каждого свода отмечено, развивается он или давно заморожен, и есть ли действующий ГОСТ. По 51 практикам из 62 проставлено соответствие COBIT.Открыть →Проекты внедрения
Проекты разного масштаба. Общее в них не инструмент, а порядок этапов: сначала описывают процесс и назначают ответственных, и только потом автоматизируют. Там, где делают наоборот, система становится ещё одним местом, куда никто не заносит заявки.
Восемь процессов ITSM собрали на одной российской платформе за пять лет
ТЭКСвыше 5000Пять лет и восемь процессов подряд: конфигурации, лицензии, мощности, ИТ-активы, финансы, изменения, инциденты и проблемы свели на одну российскую платформу и связали с ERP и кадровой системой. Ценность кейса не в размере, а в порядке: активы и конфигурации взяли раньше, чем поддержку.
Инвентаризация активов ведётся автоматически и в реальном времени, учёт связан с ERP и HRBPMSoft Конструктор, ITSMbox для BPMSoftРегламенты писали вместе с системой, а не после неё
ПромышленностьСвыше 5000На нижегородской площадке спроектировали процессы управления инцидентами, проблемами и уровнем услуг, написали под них регламенты и обучили сотрудников поддержки. Автоматизация шла не отдельно от процессов, а вместе с ними — и это в кейсе главное.
Процессы спроектированы и описаны регламентами, система развёрнута на 5000+ пользователейService Desk «Итилиум»Управление проблемами запустили как отдельную функцию, а не как процесс на бумаге
Розничная торговляСвыше 5000Управление проблемами существовало с 2017 года, охватывало не больше 3 % инцидентов и держалось на двух менеджерах, у которых были и другие задачи. Данные о причинах жили в таблицах и блокнотах. Практику запустили заново: выделенные роли, единая команда аналитиков и комитет, который решает, что признать известной ошибкой.
База инцидентов сократилась более чем на 200 тысяч обращений. Появилась отчётность по проблемам для бизнес-подразделений и для департамента поддержки; бизнес видит проблемные системы и приоритизирует доработкиСобственная ITSM-системаСмена платформы, за которой пришлось пересобирать контур поддержки
Ритейл и e-commerceСвыше 5000Сеть перешла на ITSM-систему российского разработчика. В контур вошли управление инцидентами, сбор обратной связи от пользователей и наблюдение за ходом устранения сбоев в ресторанах сети.
Единый контур ИТ-процессов после смены платформыSimpleOne ITSMКаждый разобранный проект открывается своей страницей: что болело, что сделали, что получилось и отдельно — что не получилось. Остальные проекты по этой практике — в каталоге проектов.
Примеры
Типовой инцидент. Пользователь сообщает, что не открывается отчёт. Специалист первой линии проверяет, что это не запрос на новый доступ, и регистрирует обращение. По классификации видит связь с известной ошибкой после вчерашнего релиза и применяет записанный обходной путь. Подтверждает с пользователем и закрывает. А в управление проблемами уходит отметка: обходной путь применён третий раз за неделю.
Критичный инцидент. Недоступен сервис приёма платежей. Классификация показывает влияние на выручку бизнеса — дежурный назначает координатора, тот собирает команду из инженеров базы данных и сети и открывает канал оповещения. Инженеры ведут диагностику, координатор каждые пятнадцать минут пишет статус. После восстановления обязателен разбор — не для поиска виноватых, а чтобы понять, почему обнаружили не мониторингом.
Где практика не применяется. Запланированные работы — не инциденты. Заявка на новый доступ — тоже: это запрос на обслуживание, а почему его нельзя держать в одном потоке с инцидентами, разобрано выше. Сервисные работы по расписанию, миграции и плановые остановки идут своими процессами, даже если внешне выглядят как простой ИТ-услуги.
Комплект документов
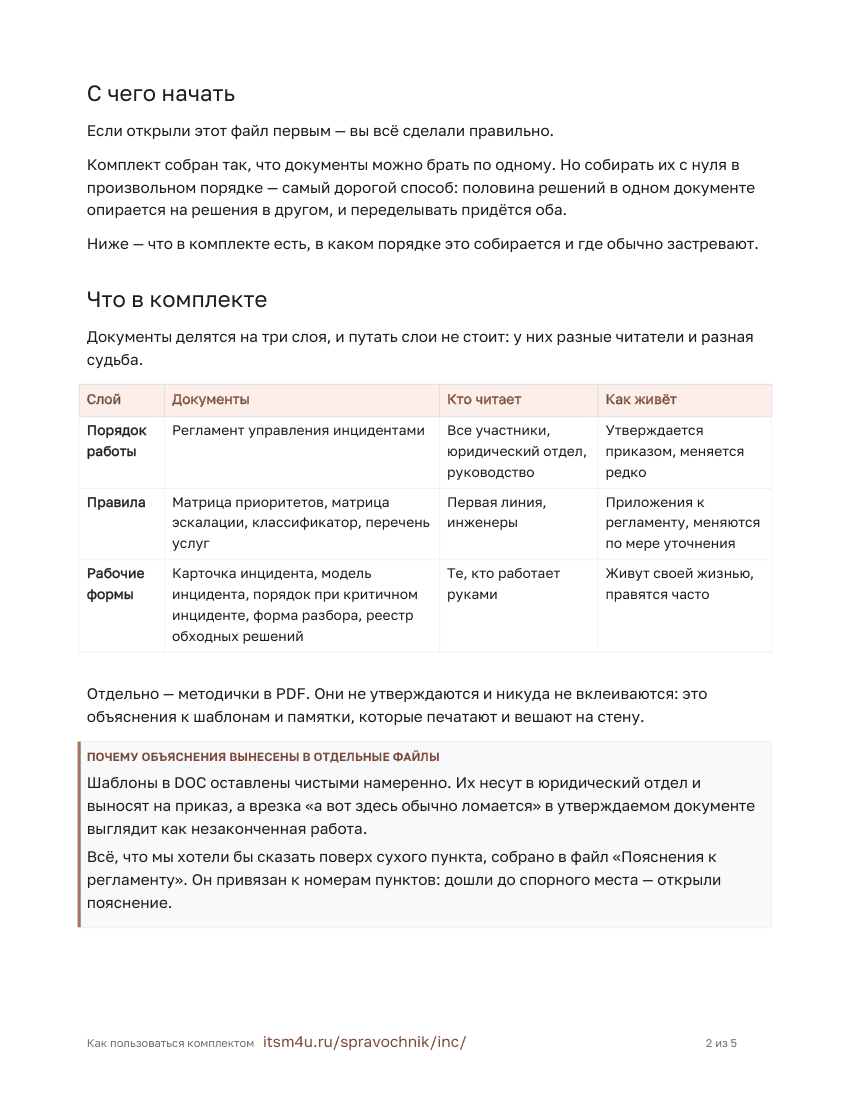
Практику не внедряют чтением. Ниже — 23 документа, собранные из этого же текста: 15 шаблонов, которые заполняют и выносят на приказ, и 8 методичек, которые объясняют, что и в каком порядке делать. Всё открыто и скачивается без регистрации.
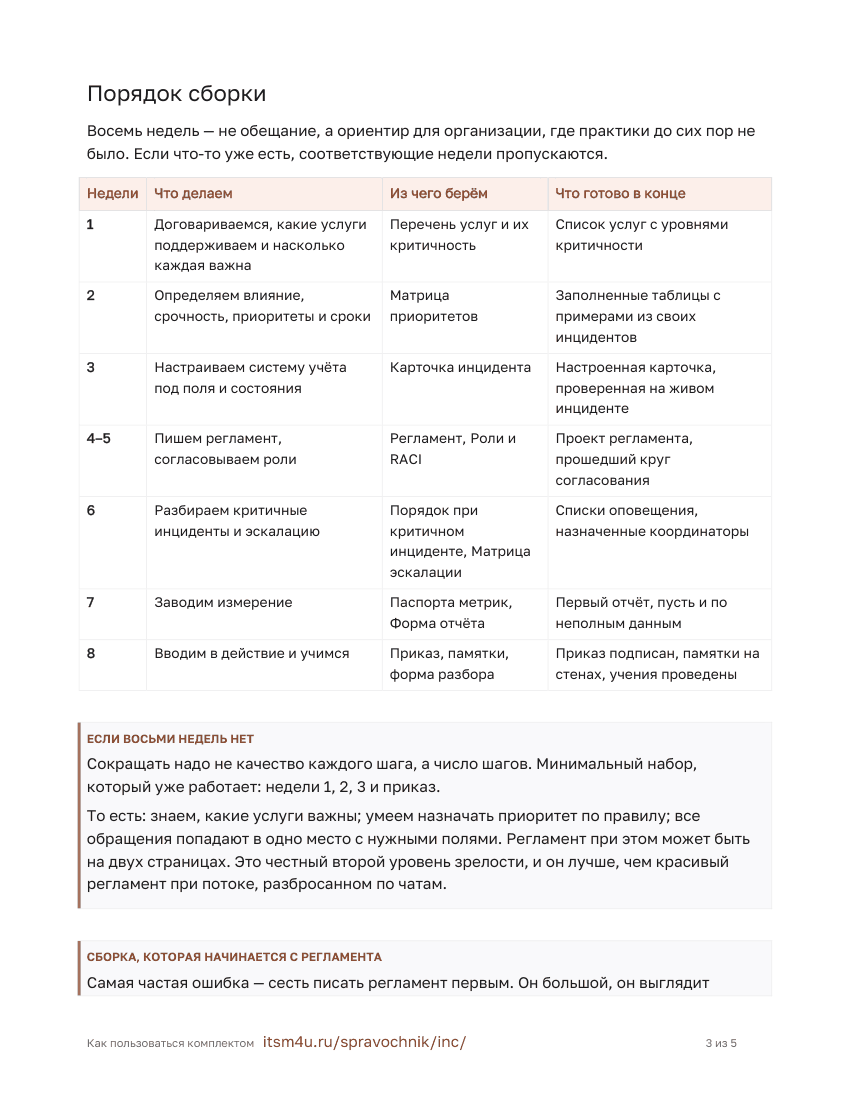
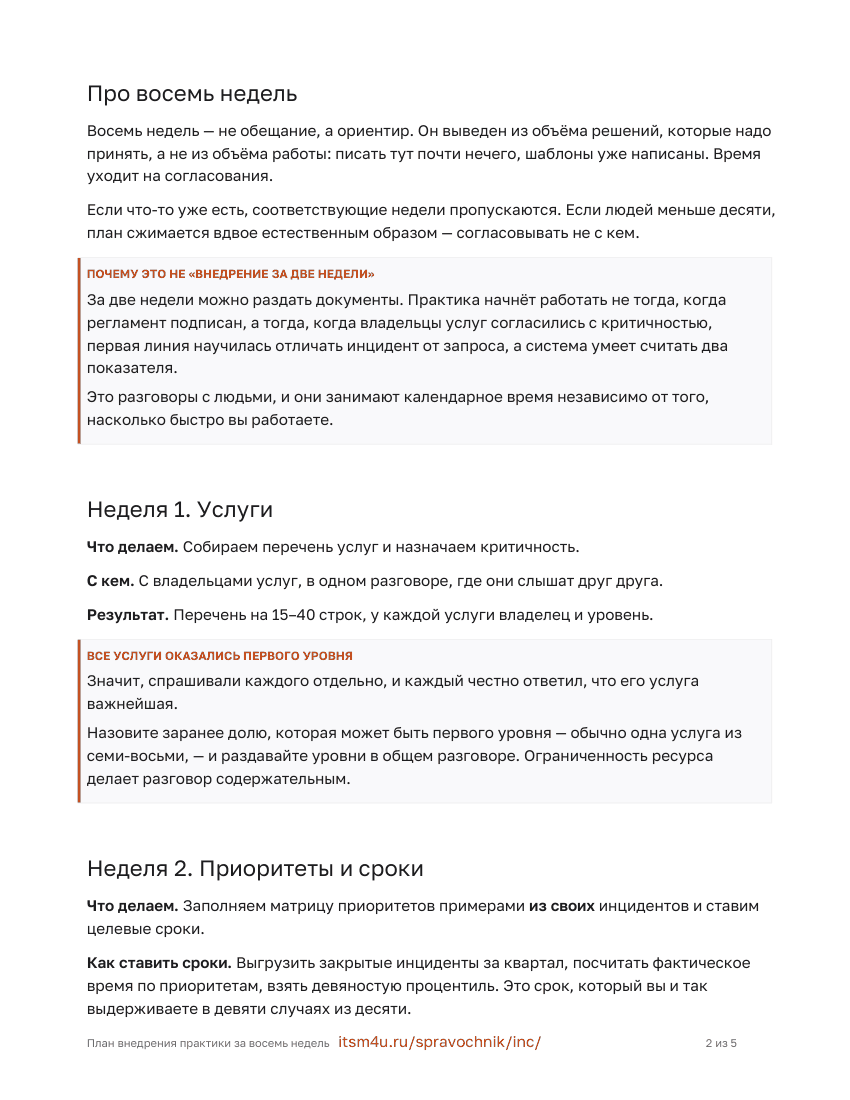
Порядок сборки важнее состава. Сначала услуги, потом приоритеты, потом настройка системы учёта, и только четвёртым — регламент: он ссылается на всё перечисленное, и написанный первым переписывается наполовину через две недели. Поэтому группы ниже идут в том порядке, в каком их разумно проходить.
23 документа · 15 в DOC, 8 в PDF · 169 страниц · Комплект открыт целиком: ни регистрации, ни подписки.
С чего начать
Прочитать до того, как открывать шаблоны
Как пользоваться комплектом
Карта комплекта и порядок сборки. Открывать первым
Управление инцидентами
Практика на двенадцати страницах: цель, устройство, показатели
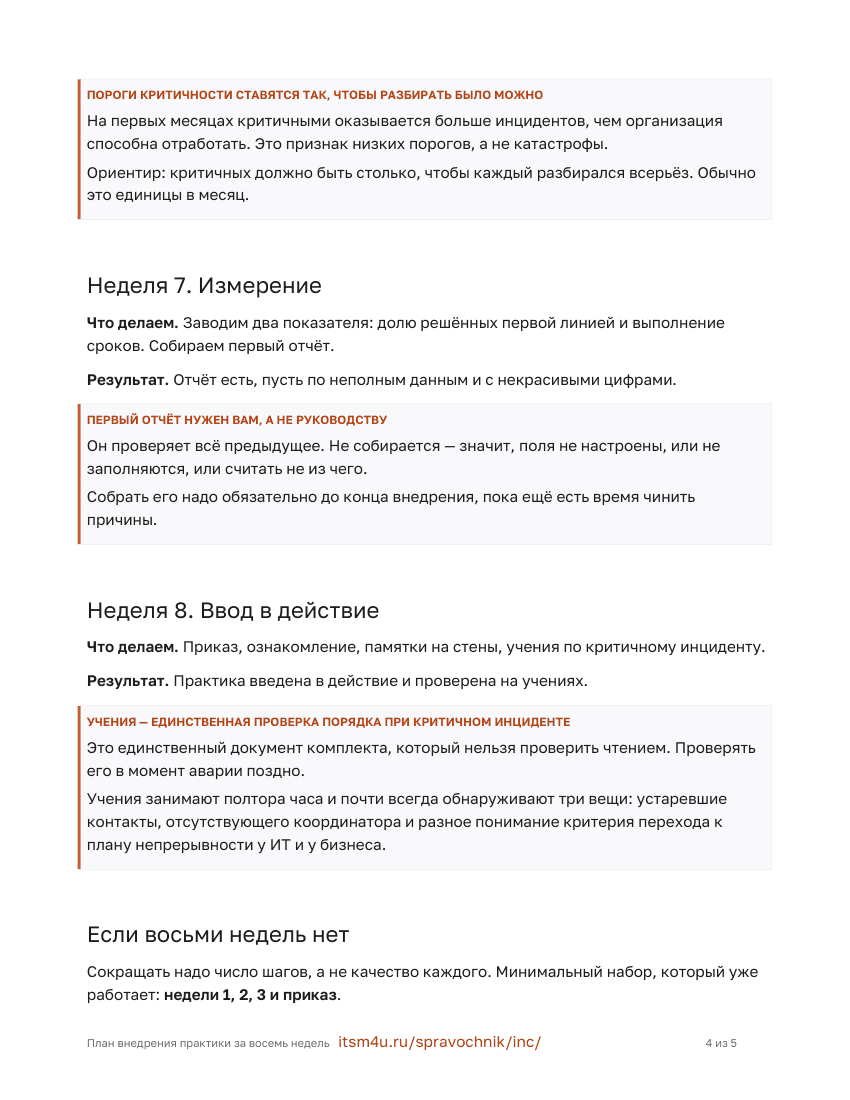
План внедрения практики за восемь недель
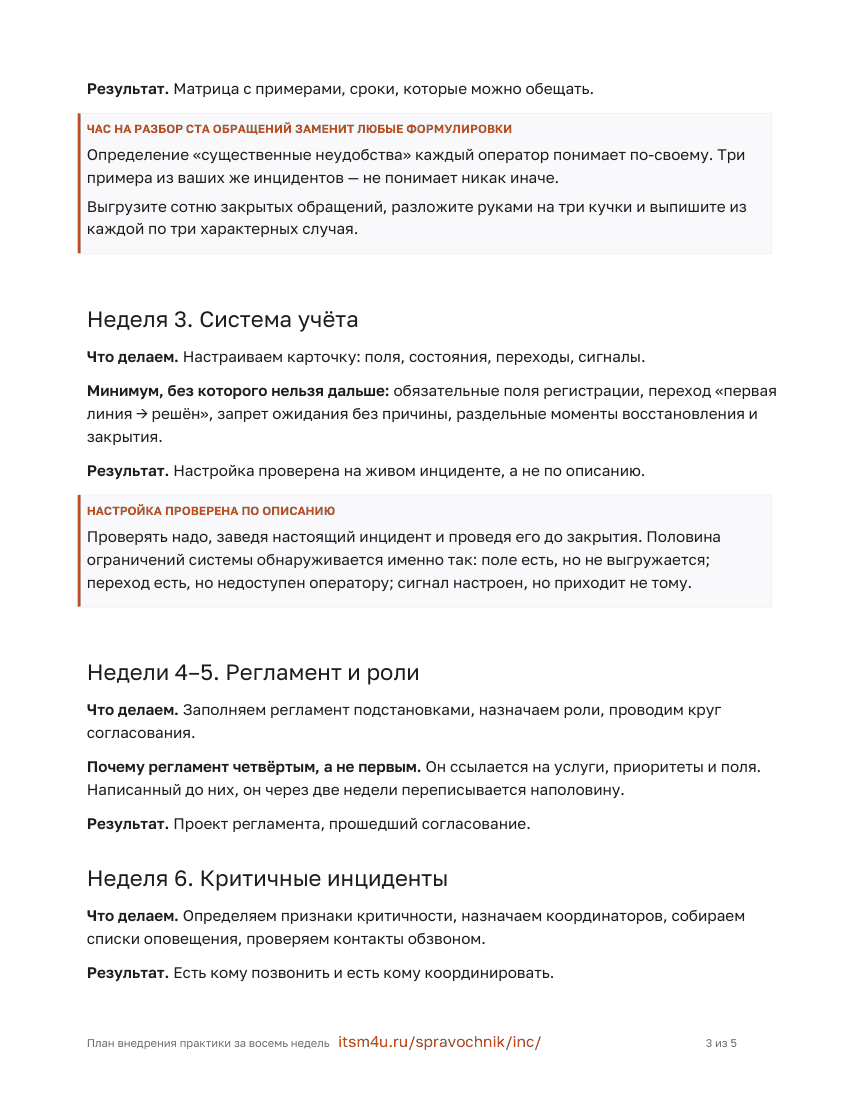
Что делать по неделям, если практики до сих пор не было
Правила, которые надо решить
Решения, на которые ссылается всё остальное. Собираются первыми
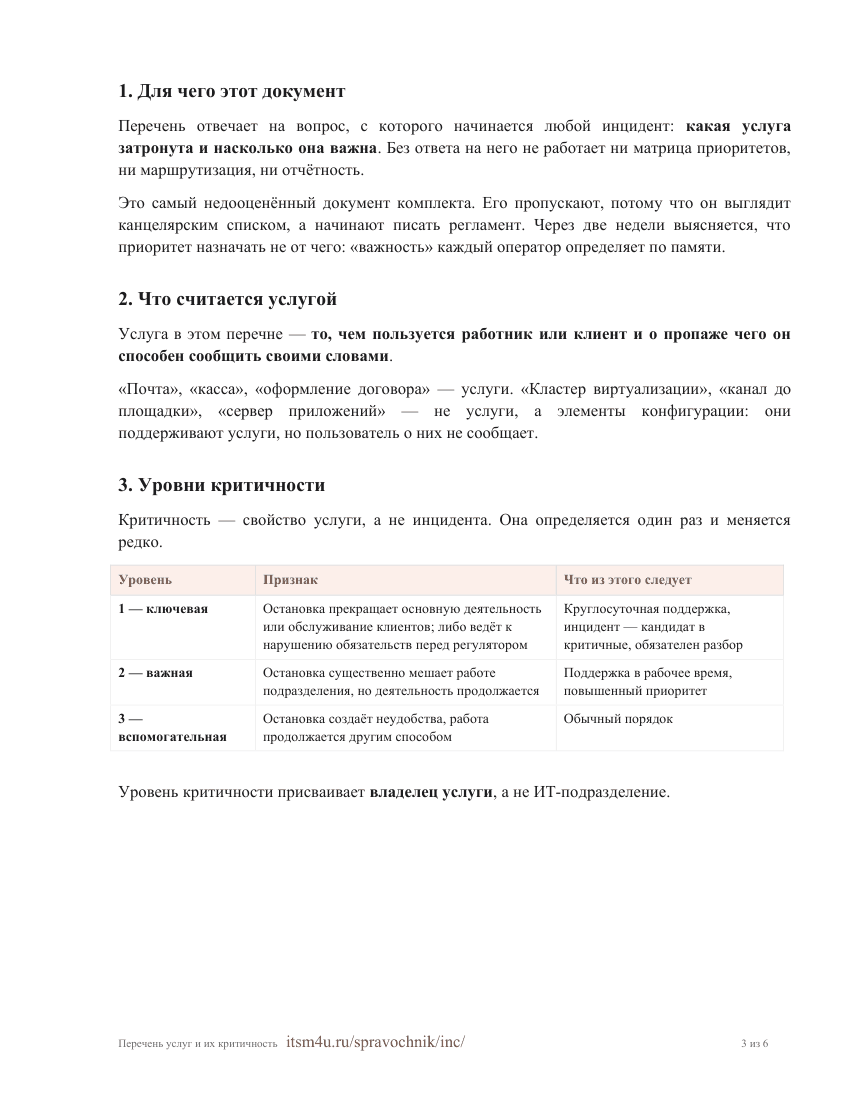
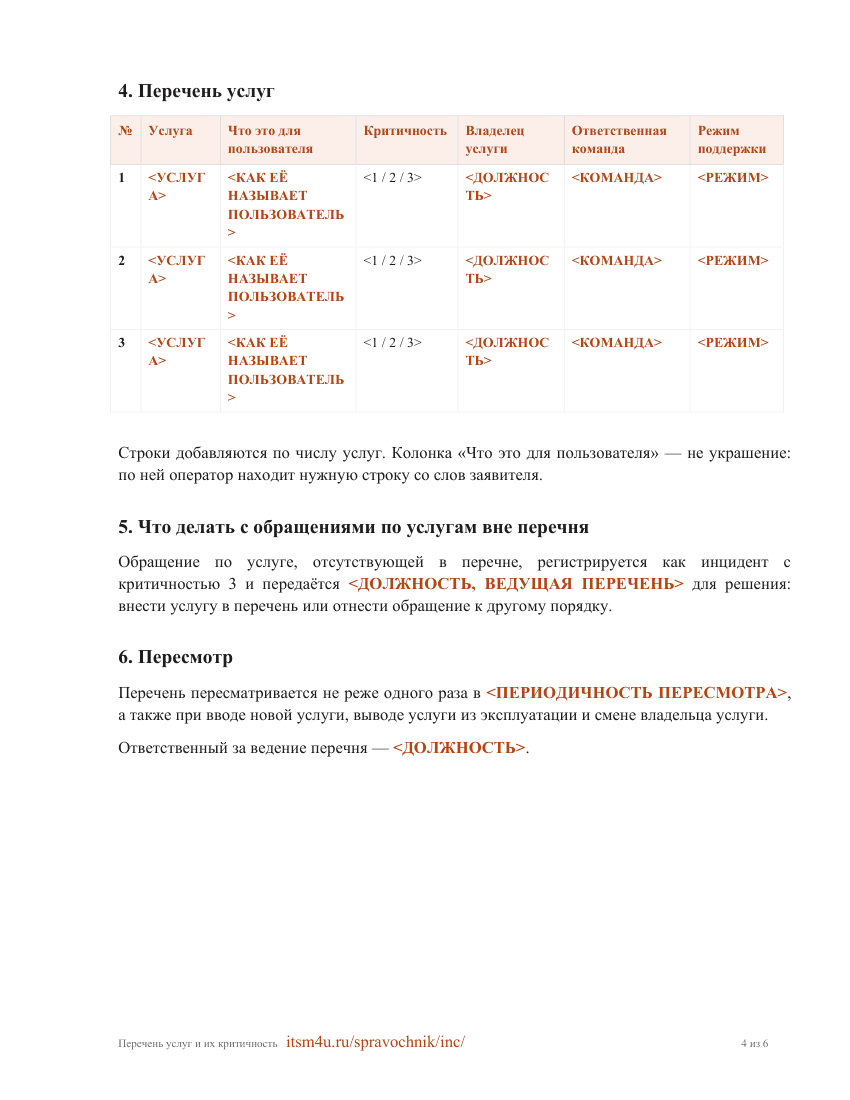
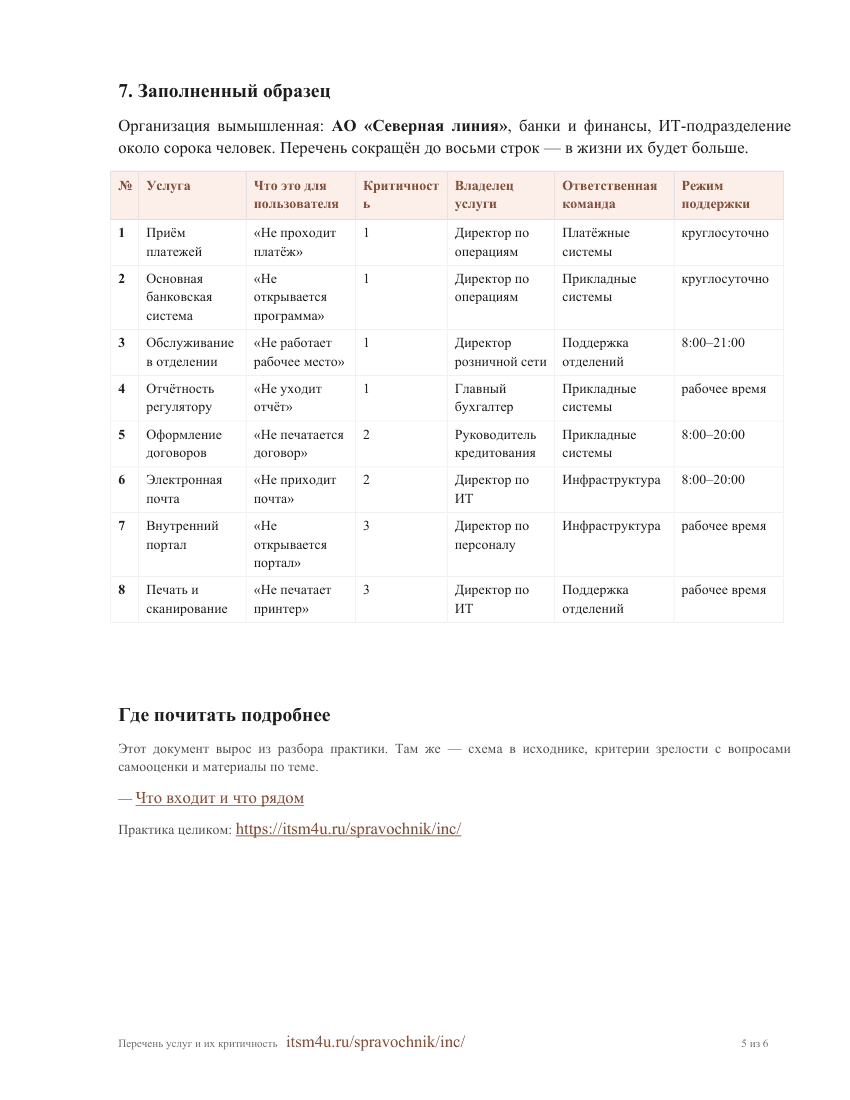
Перечень услуг и их критичность
Какие услуги поддерживаем и насколько каждая важна
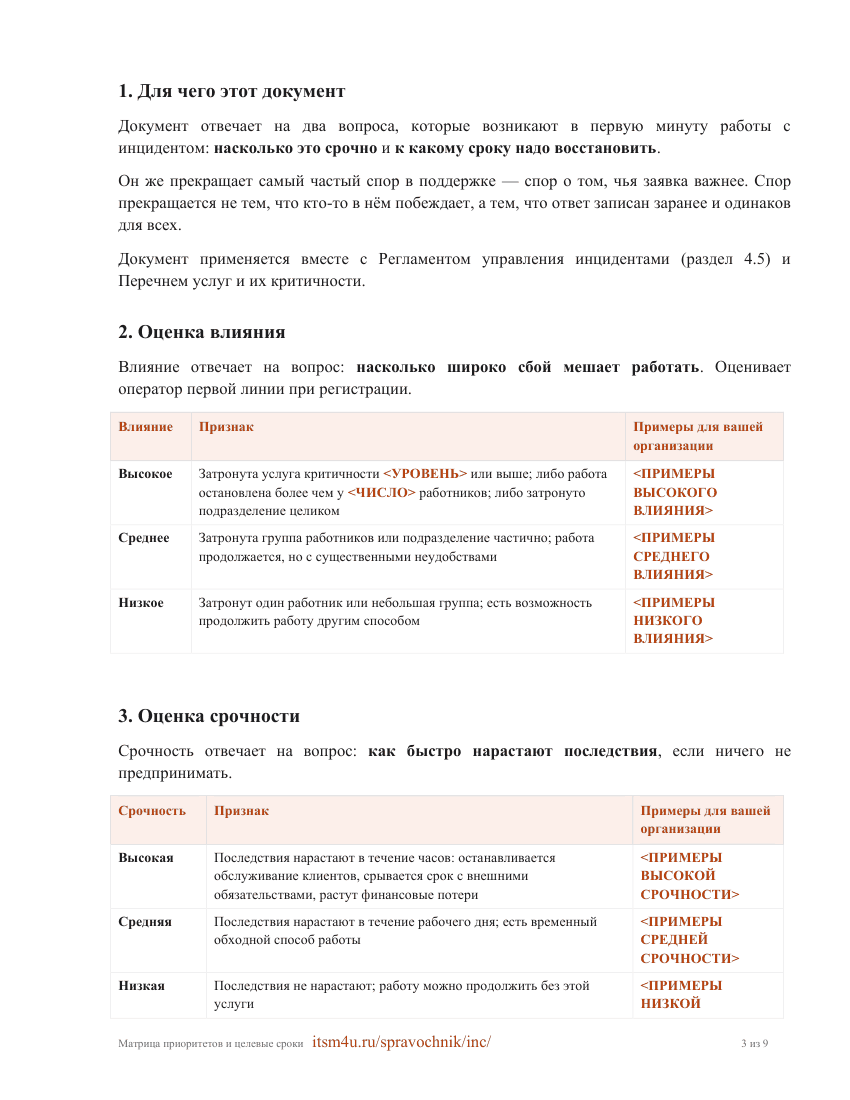
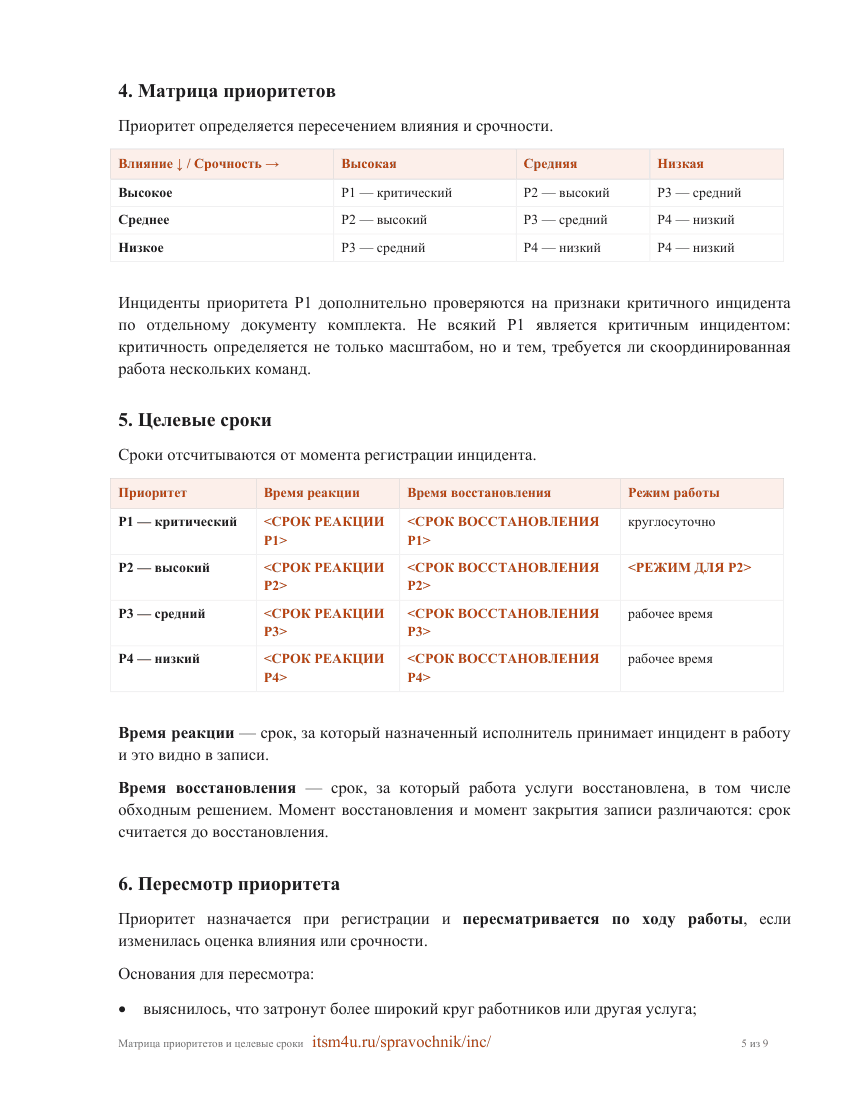
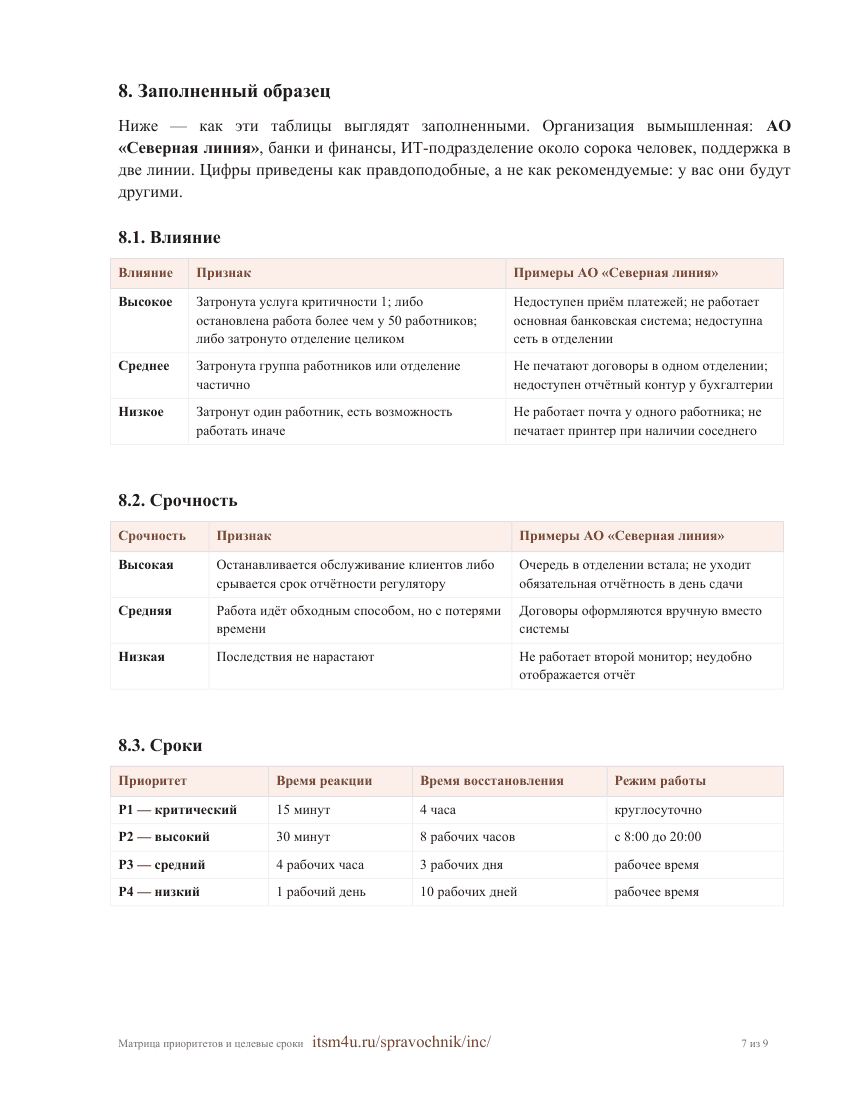
Матрица приоритетов и целевые сроки
Влияние × срочность → приоритет → срок. С заполненным образцом
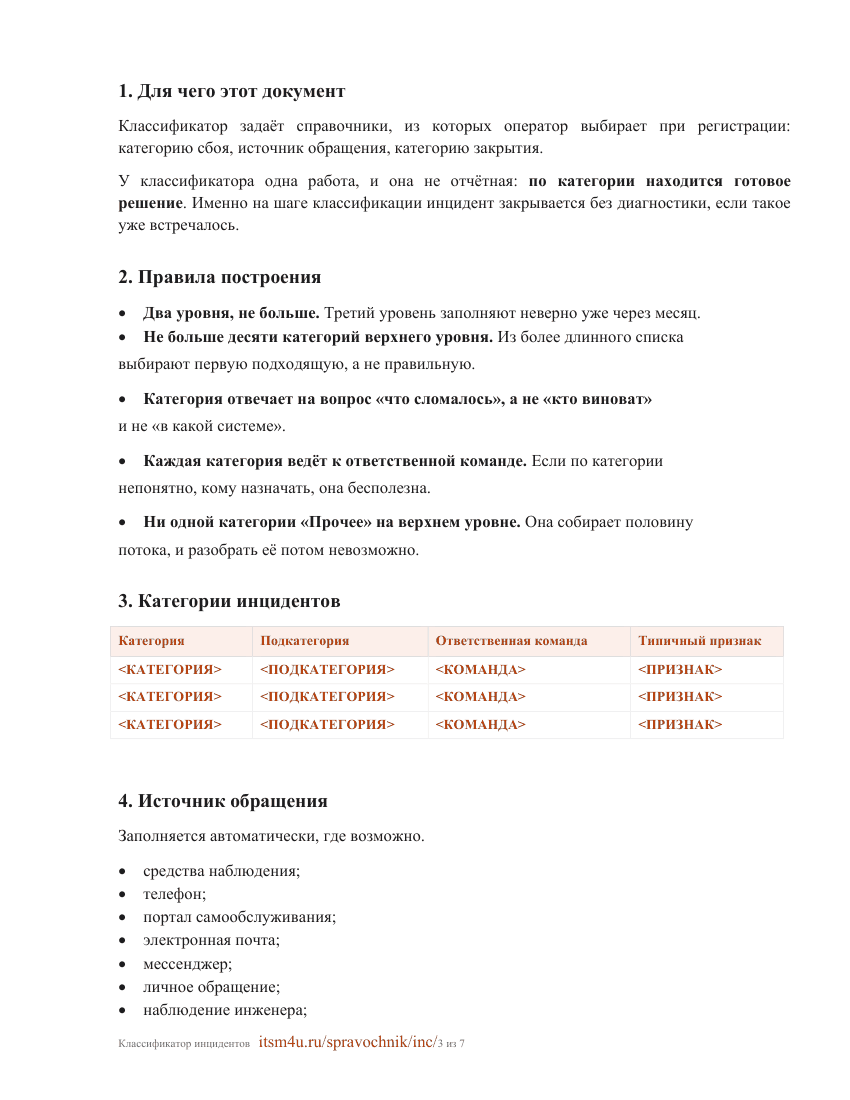
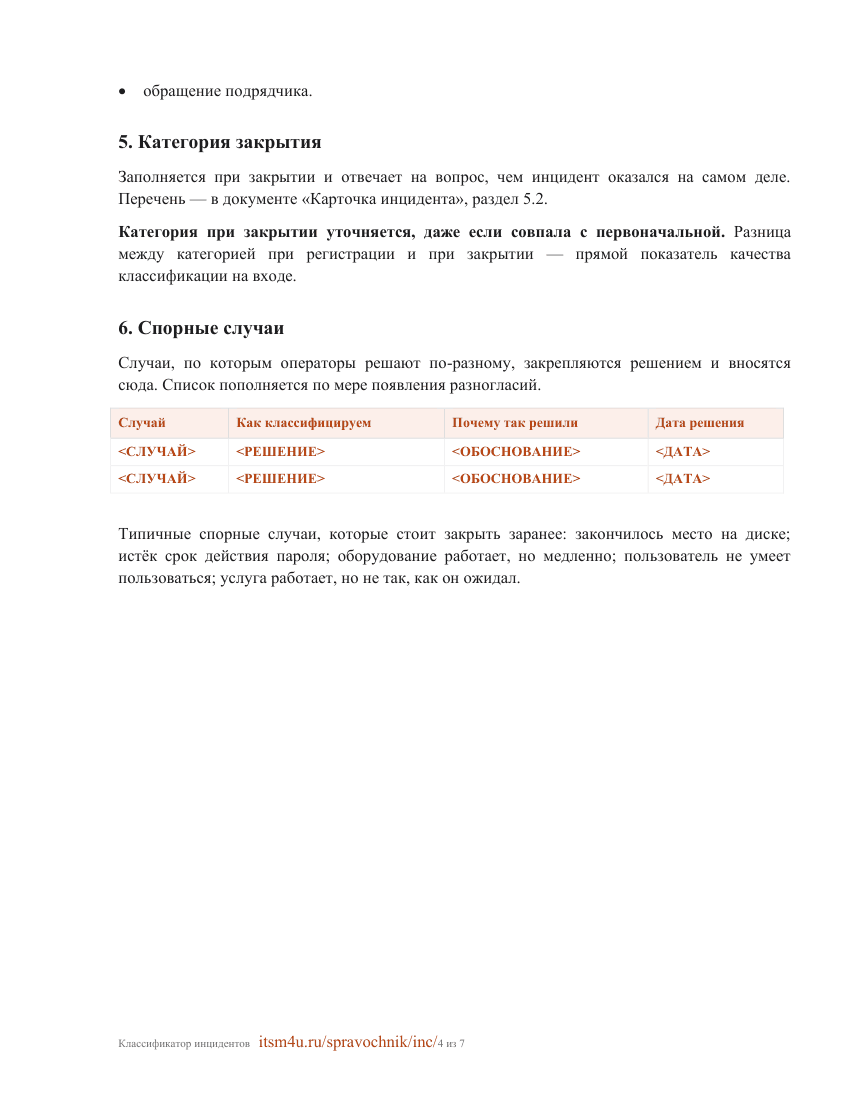
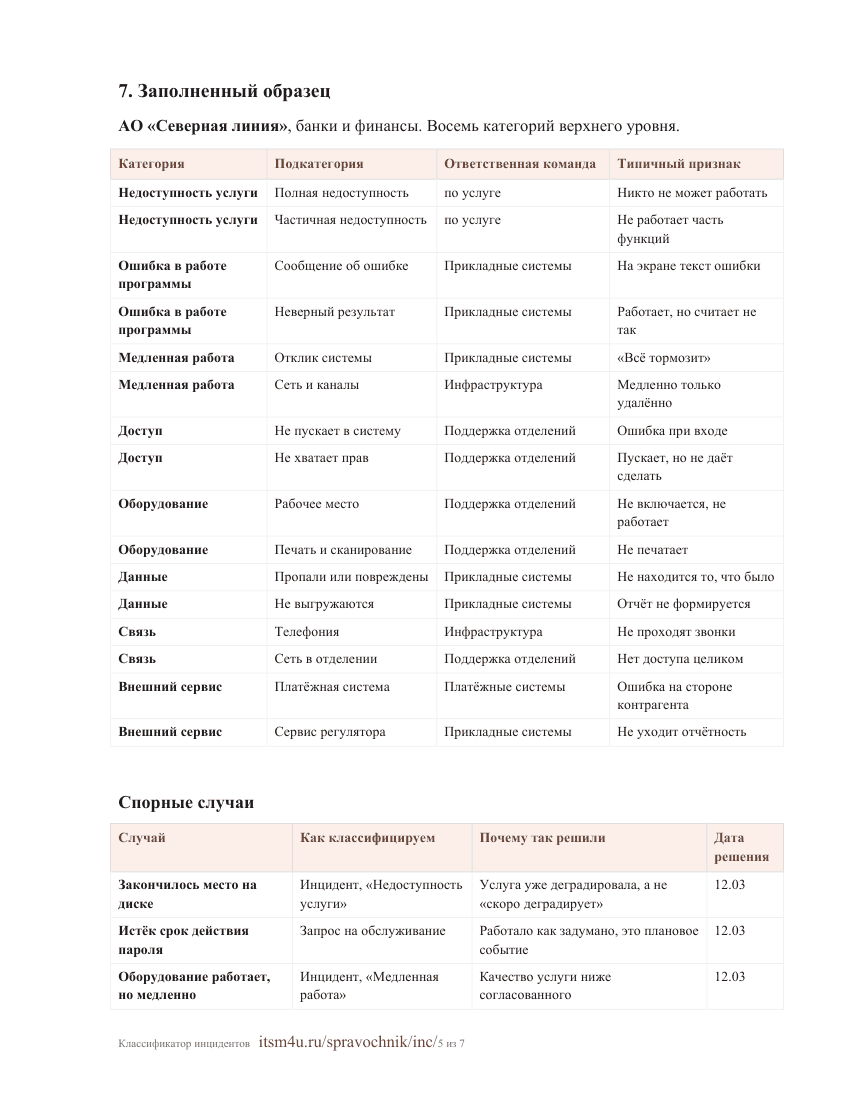
Классификатор инцидентов
Справочники: категории, источники, категории закрытия
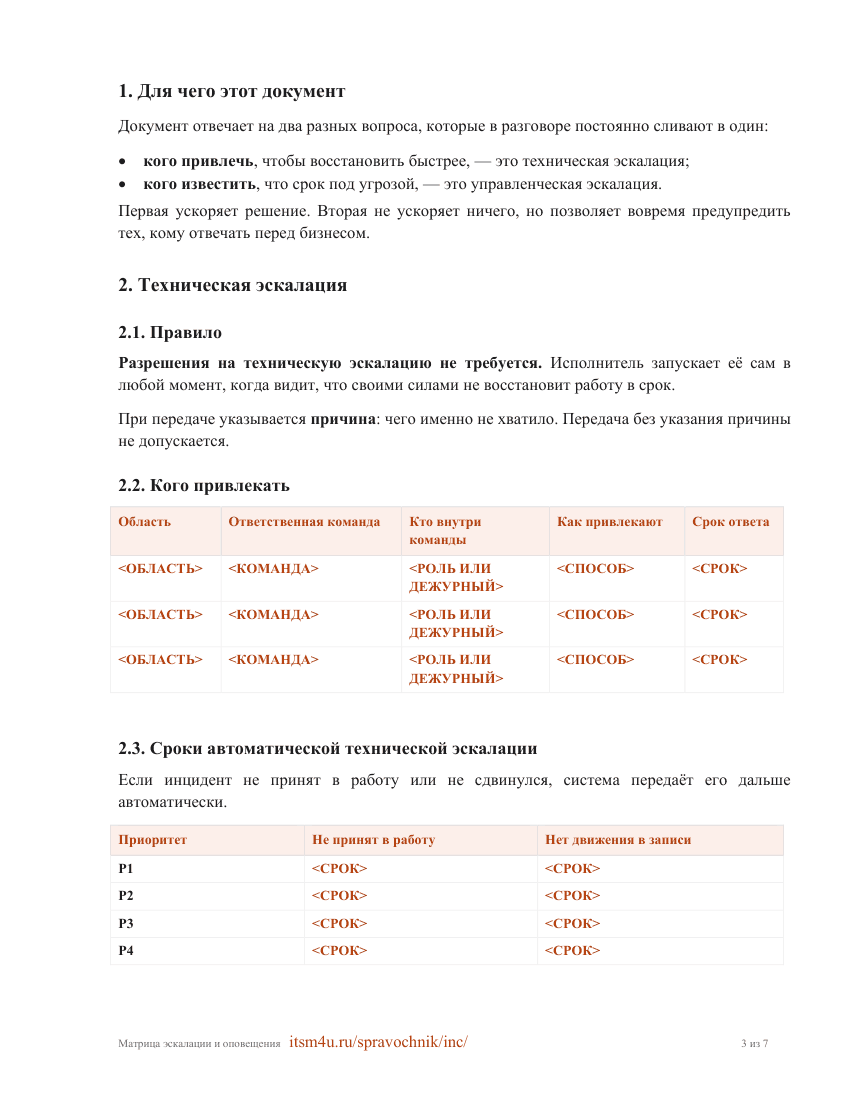
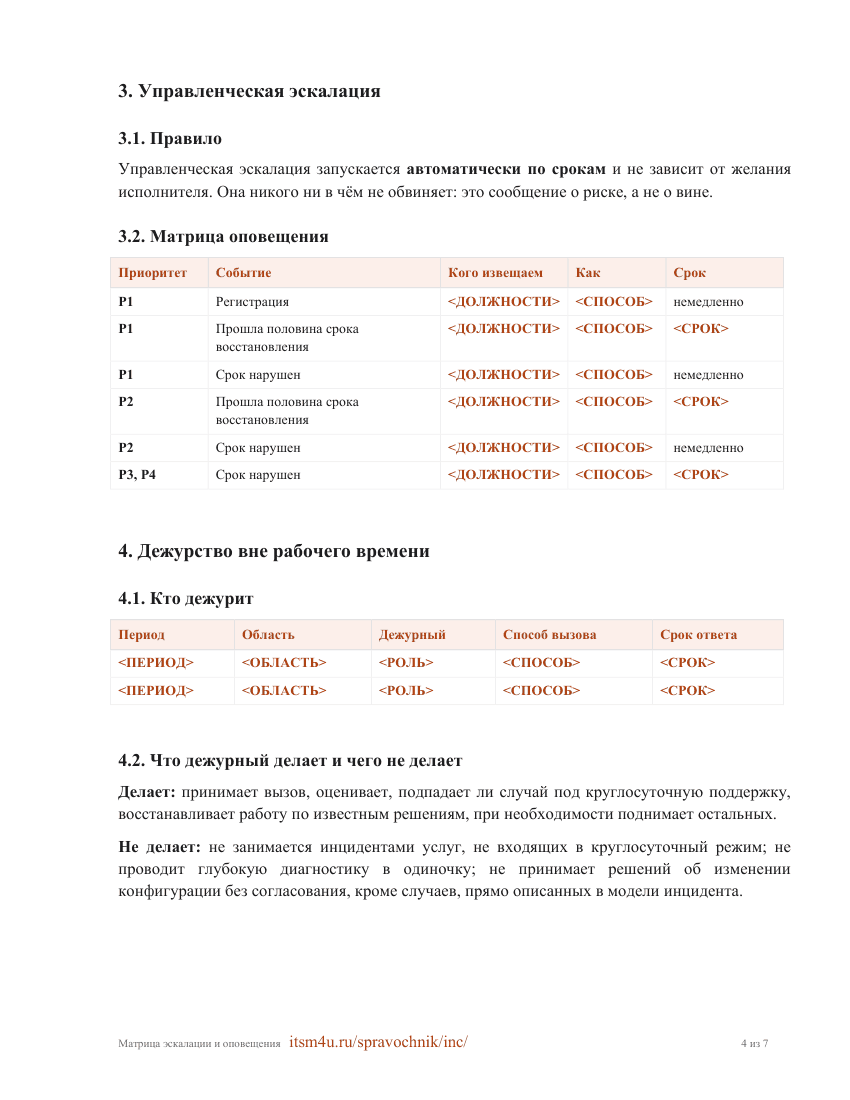
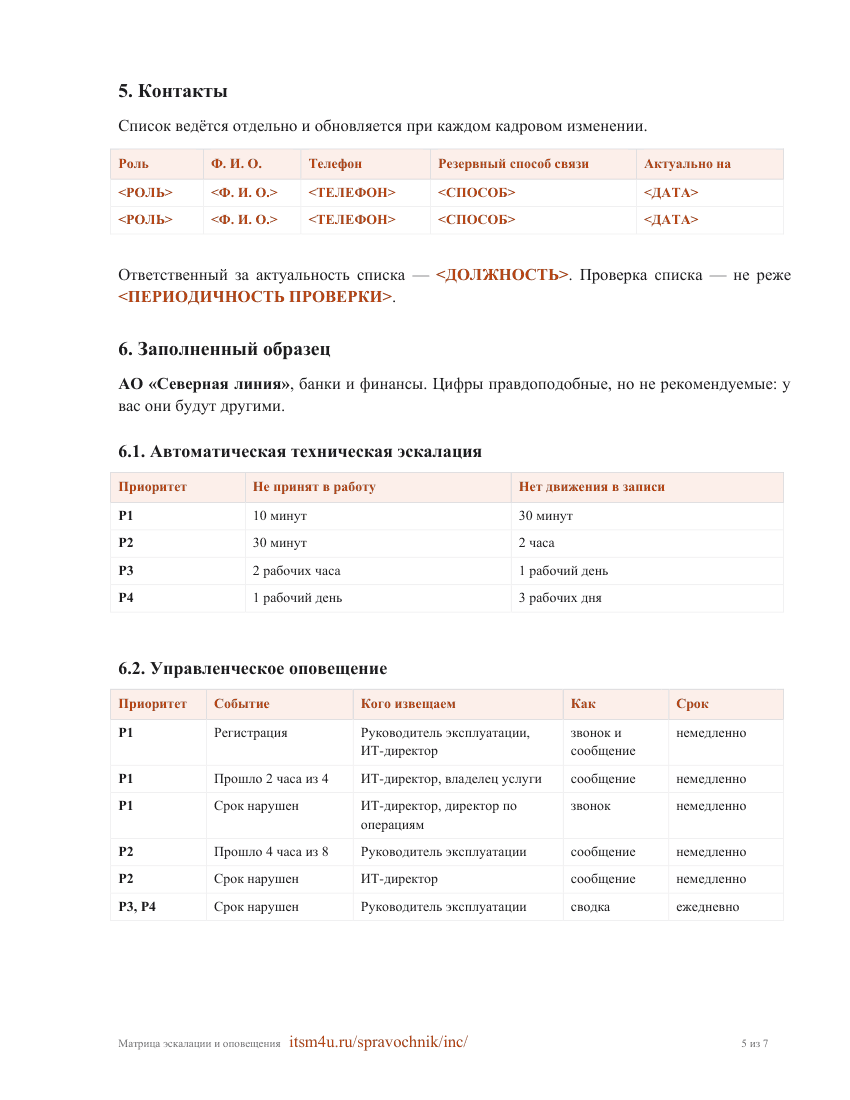
Матрица эскалации и оповещения
Кого привлекать и кого извещать. Две эскалации, а не одна
Порядок работы
Головной документ практики и то, что к нему прилагается
Регламент управления инцидентами
Головной документ: границы, роли, порядок работы, эскалация
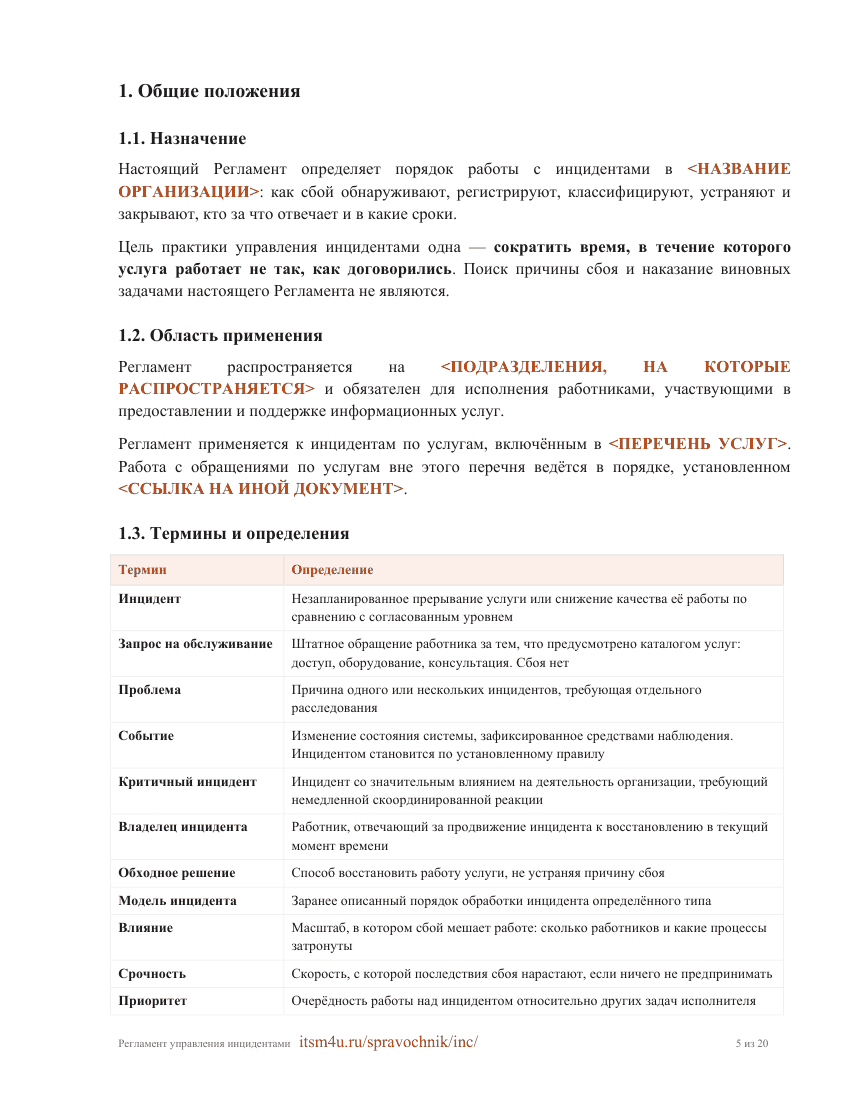
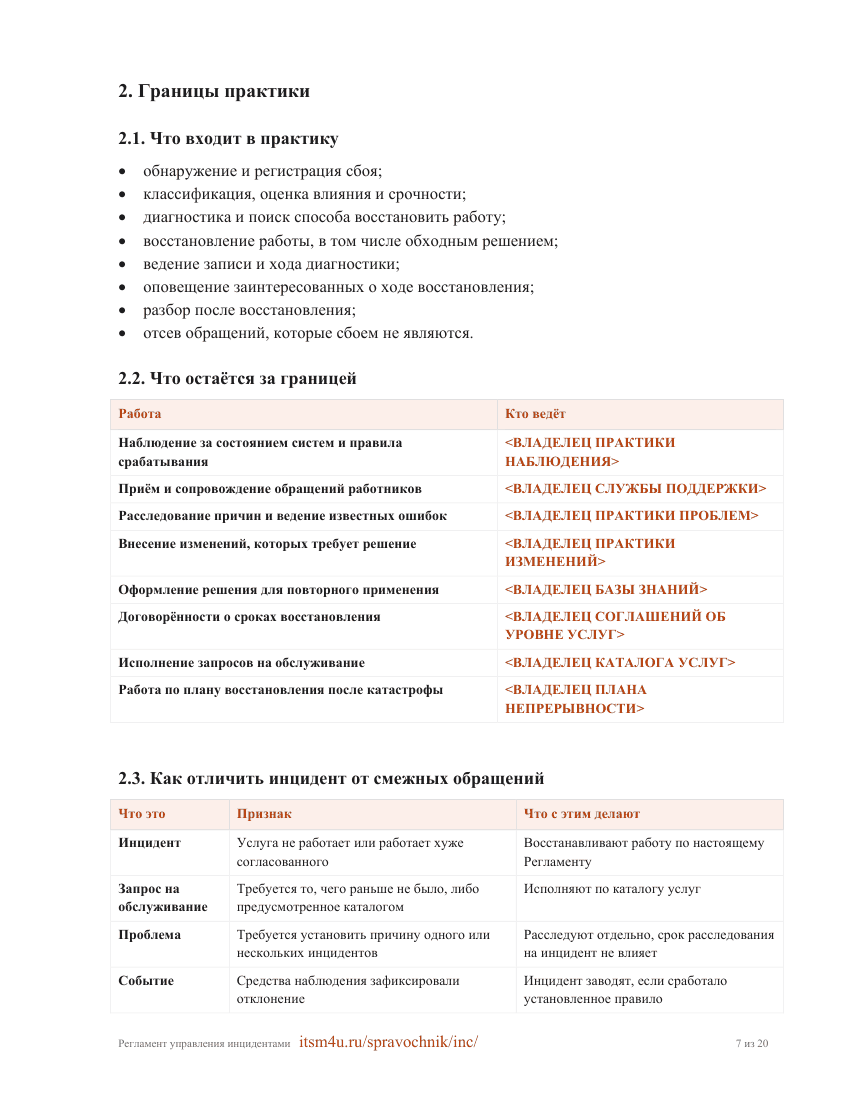
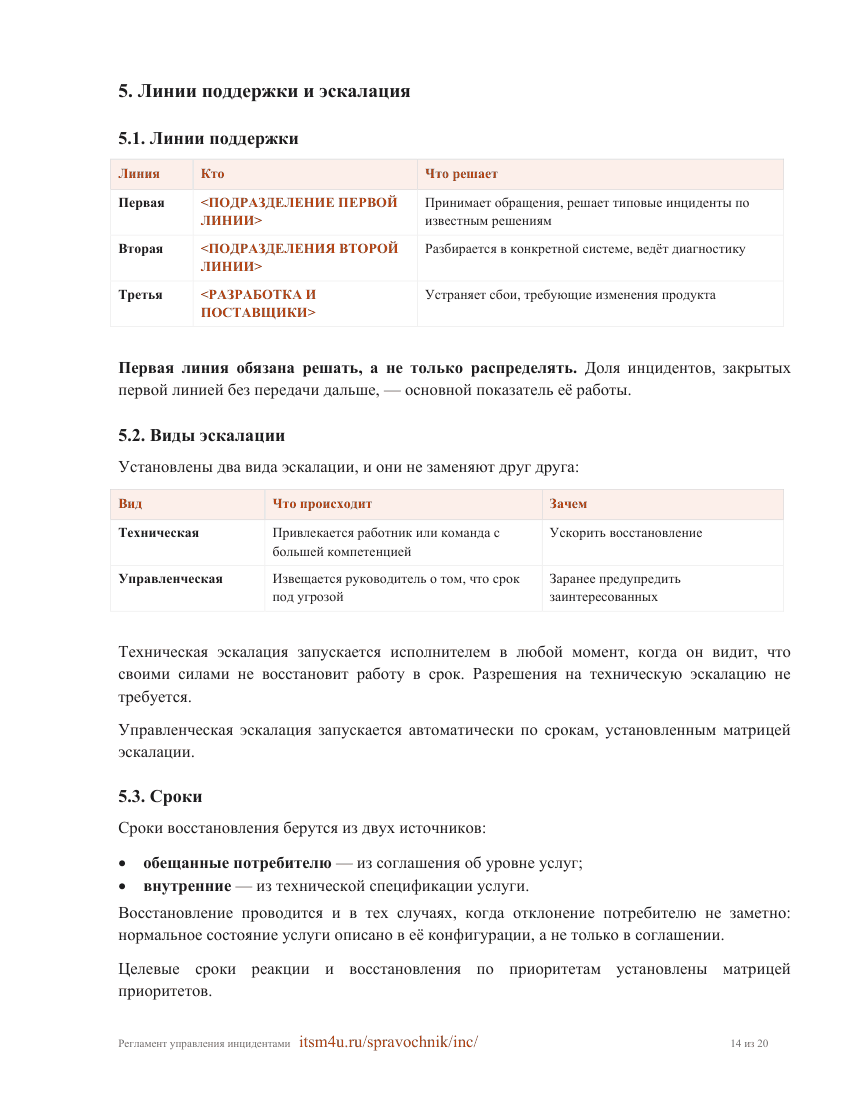
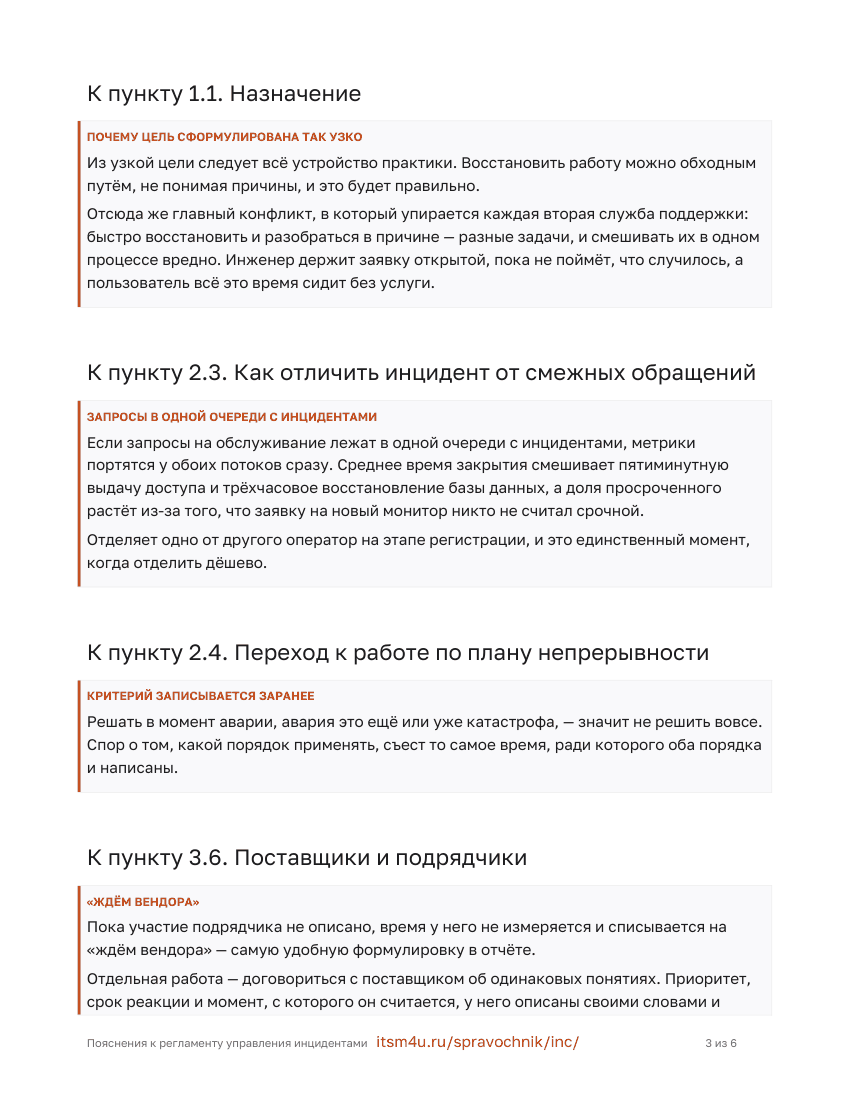
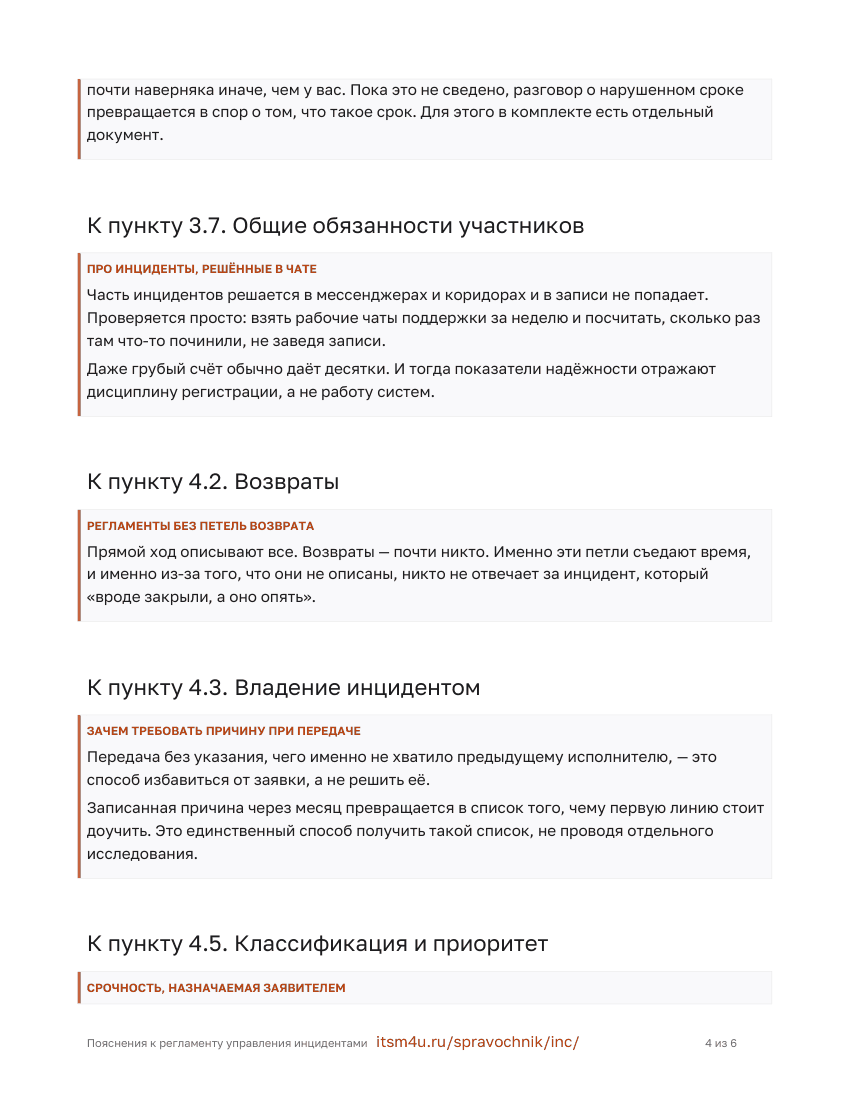
Пояснения к регламенту управления инцидентами
Постатейно к регламенту: что имелось в виду и как это ломается
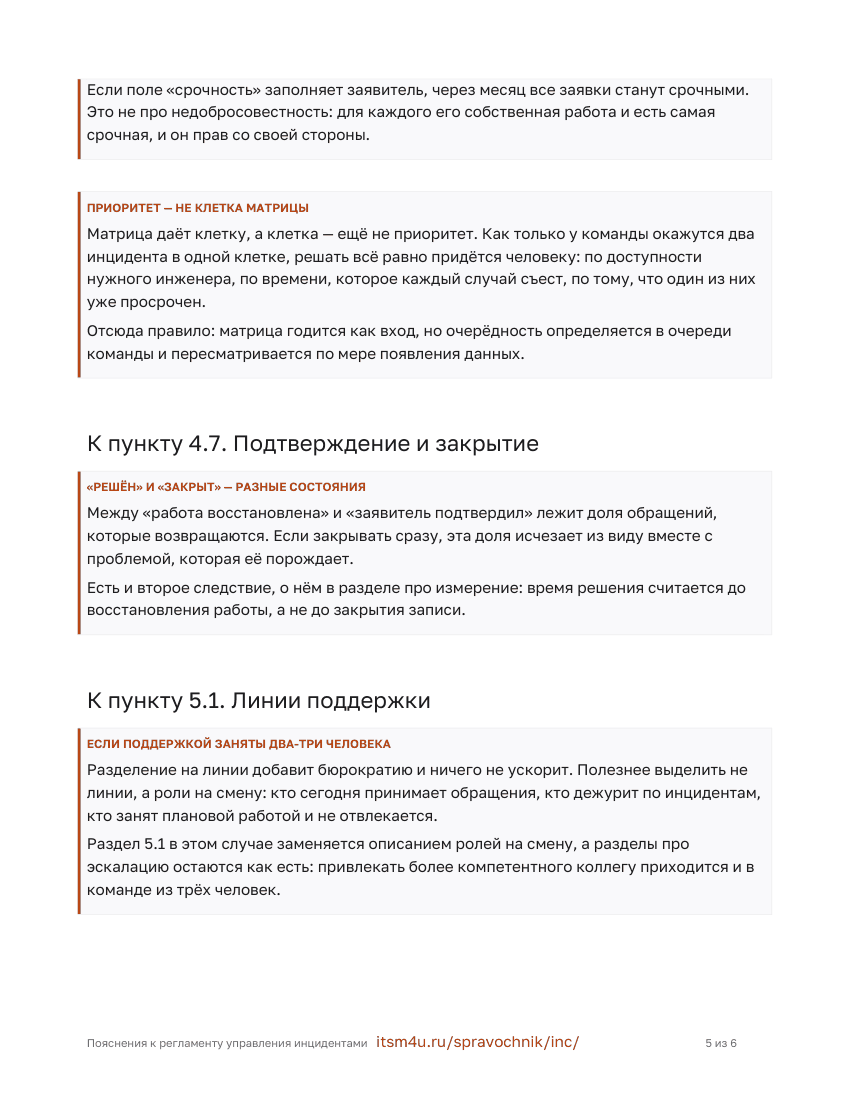
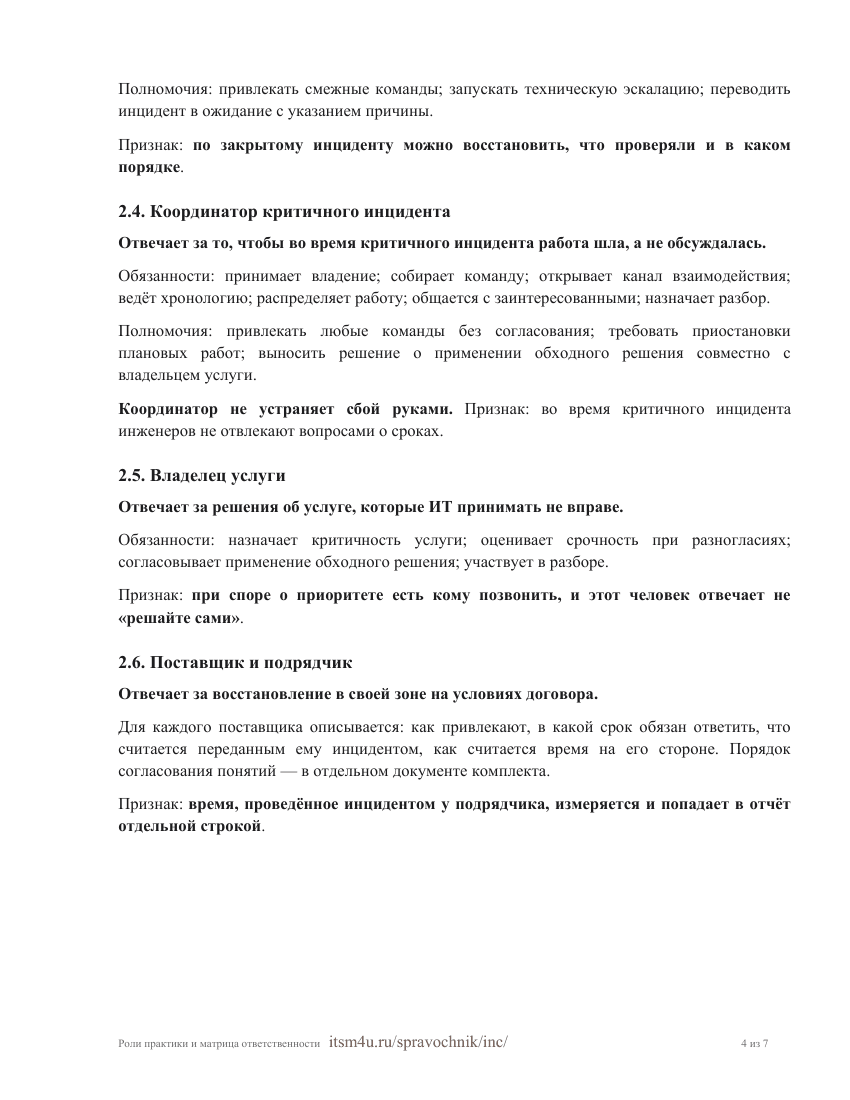
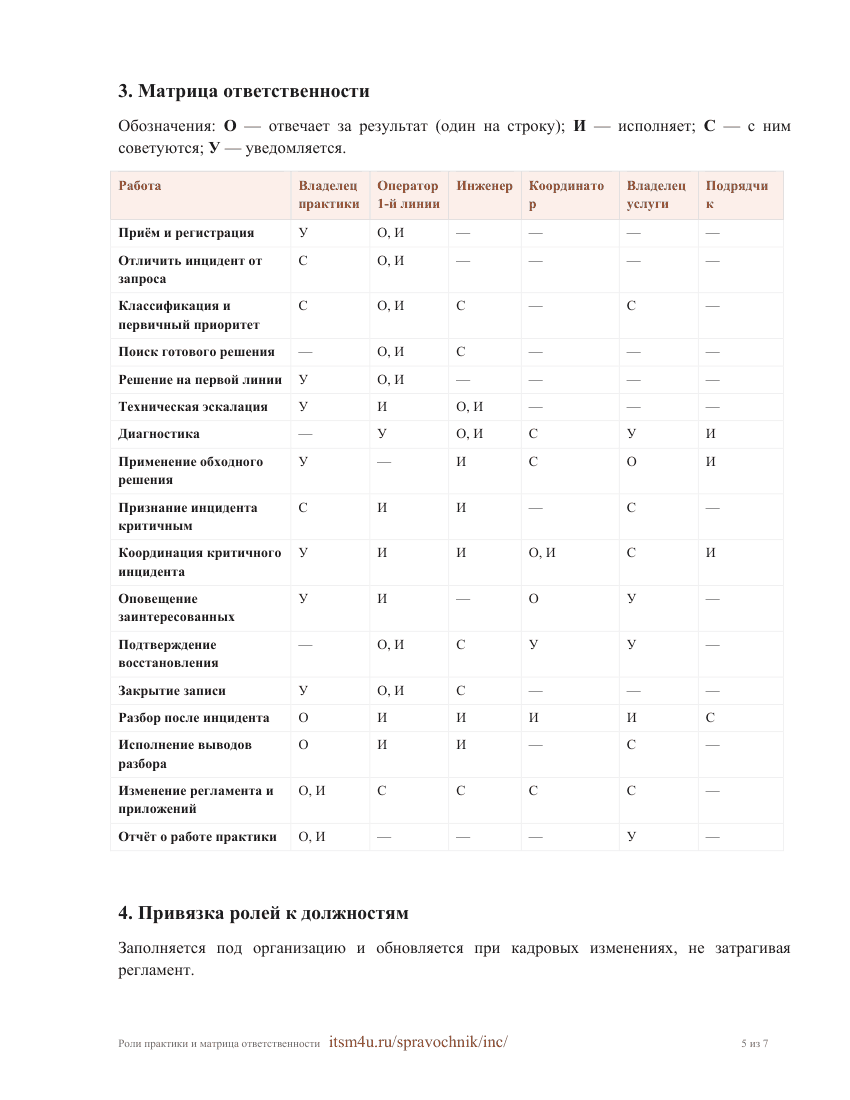
Роли практики и матрица ответственности
Пять ролей и матрица ответственности на семнадцать работ
Согласование понятий с подрядчиком
Свести понятия с подрядчиком до первого нарушенного срока
Рабочие формы
То, чем пользуются каждый день и во время аварии
Карточка инцидента: поля, состояния, переходы
Задание на настройку системы: поля, состояния, переходы
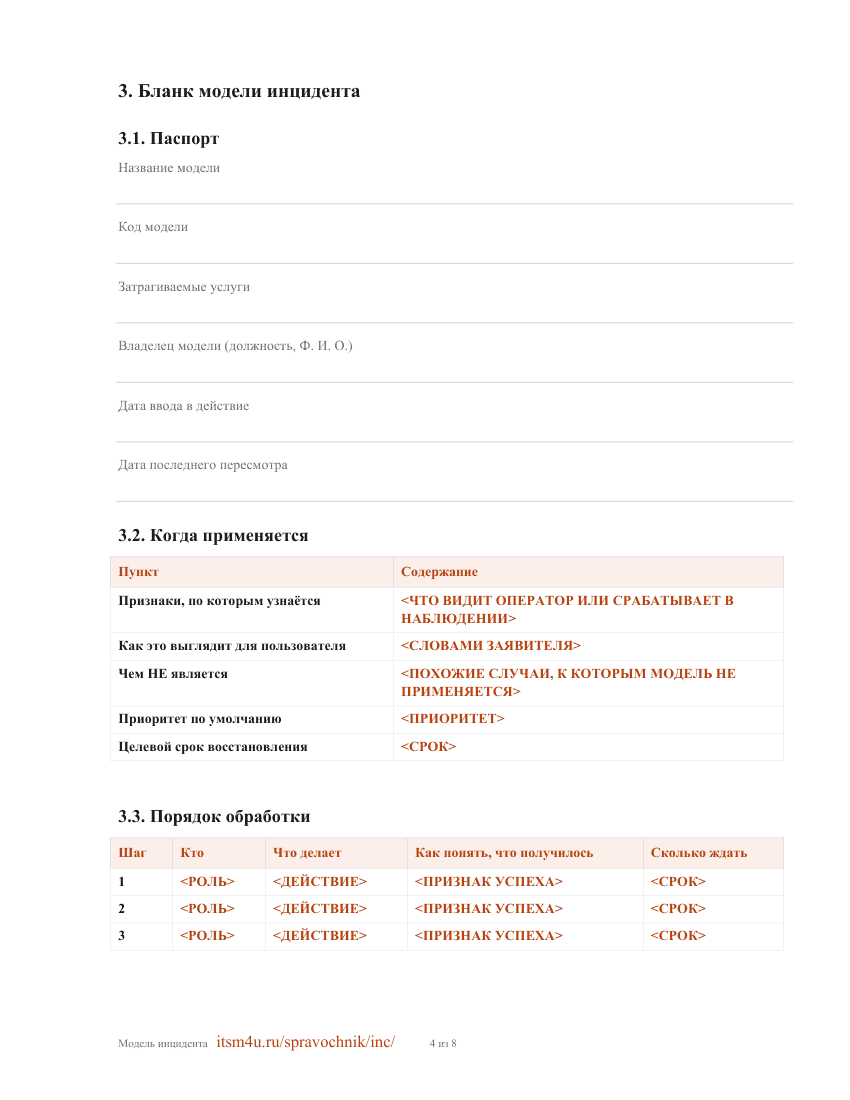
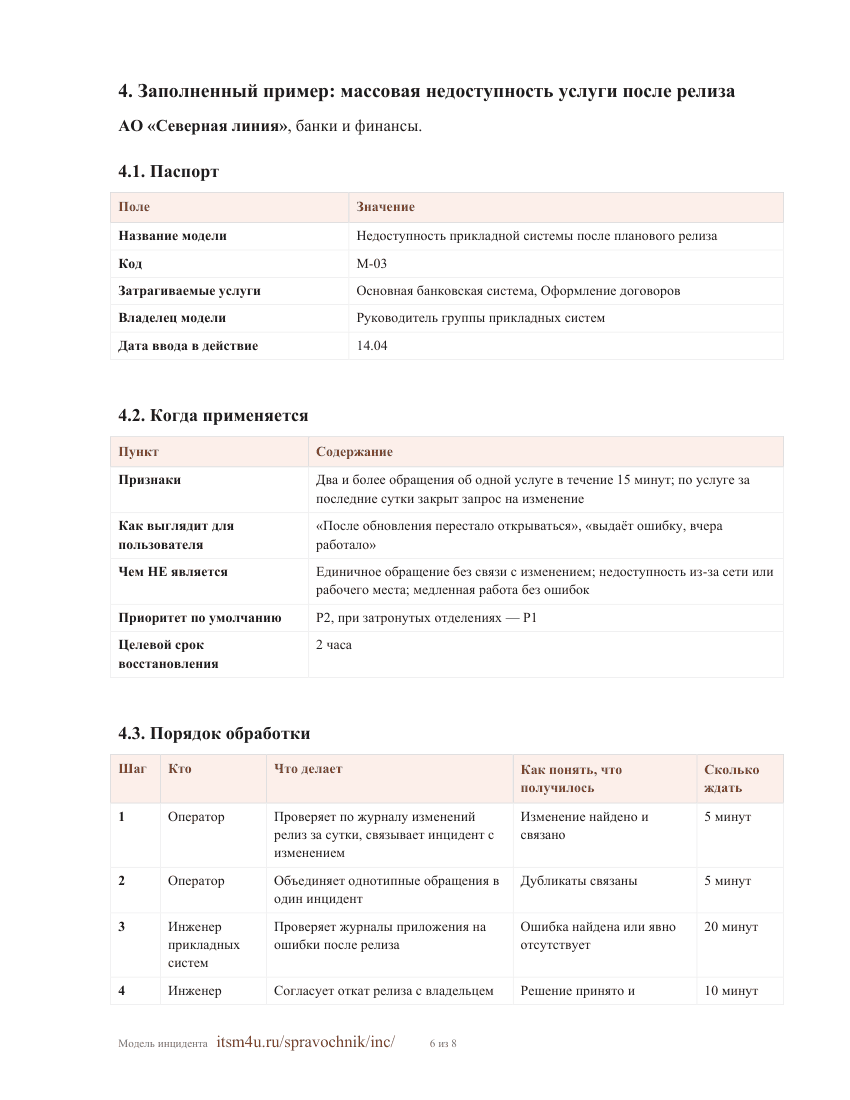
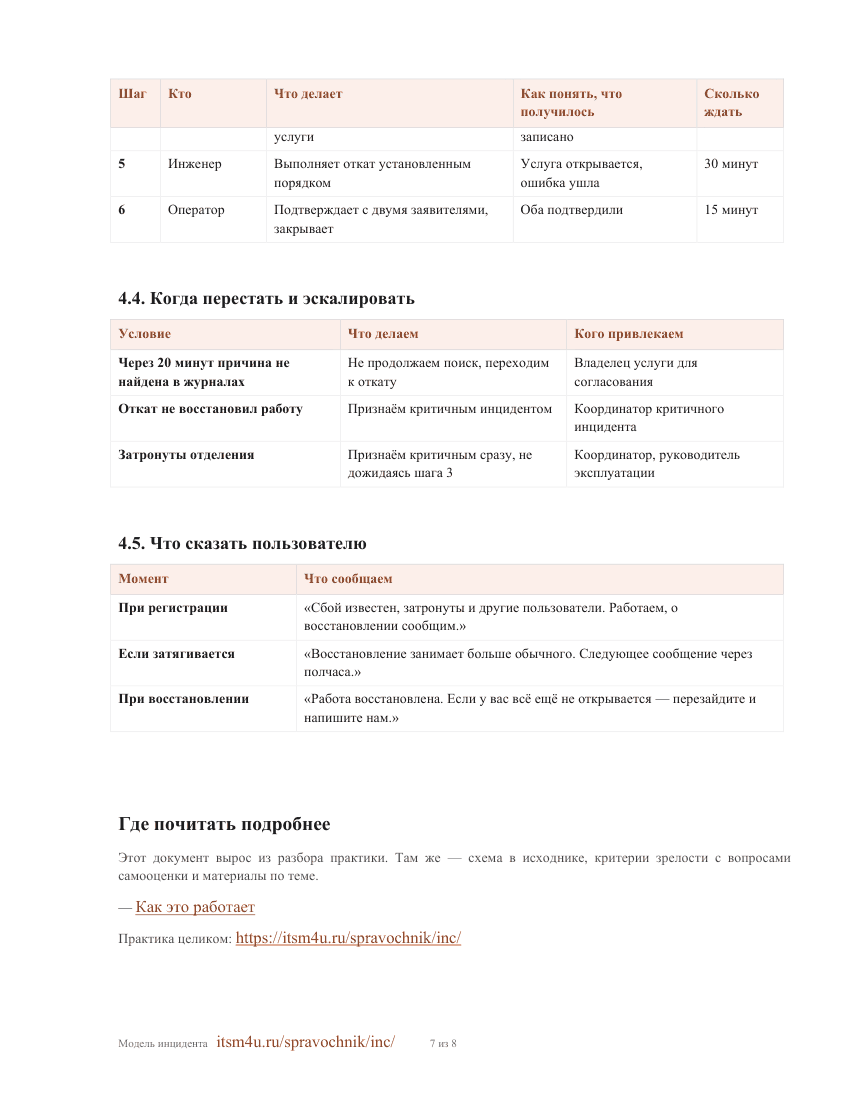
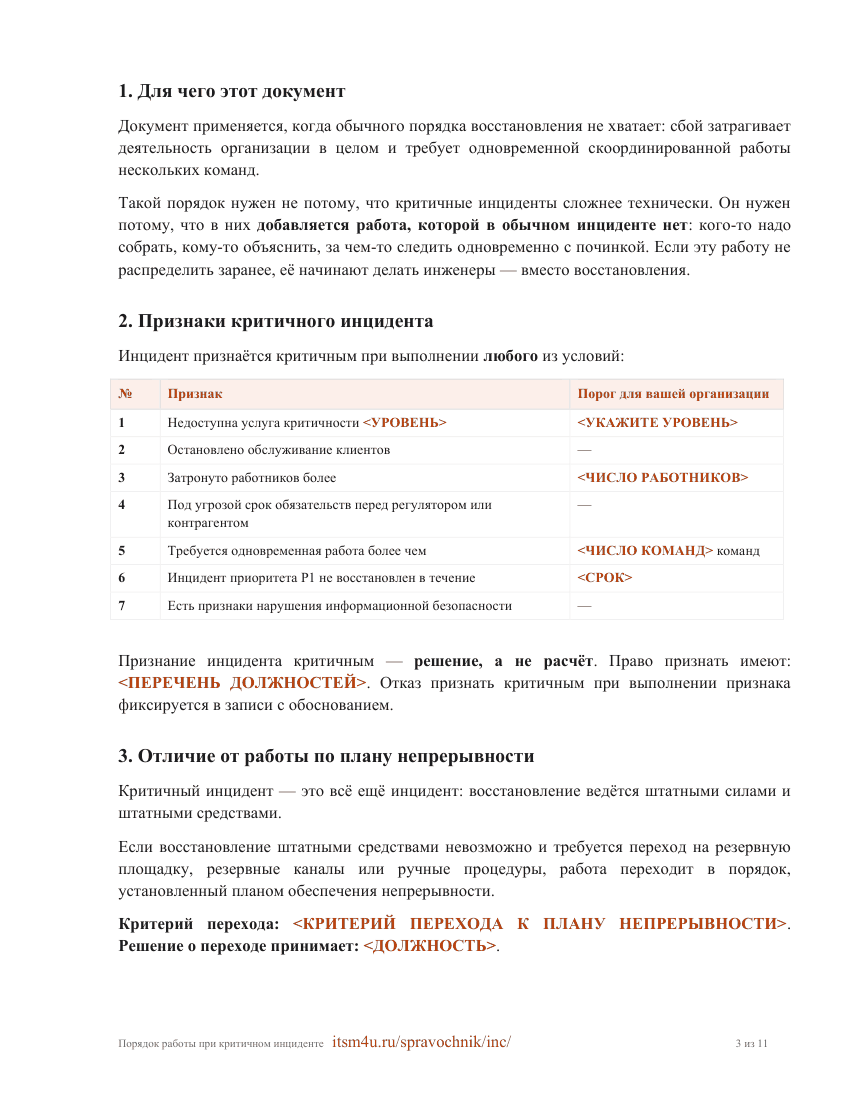
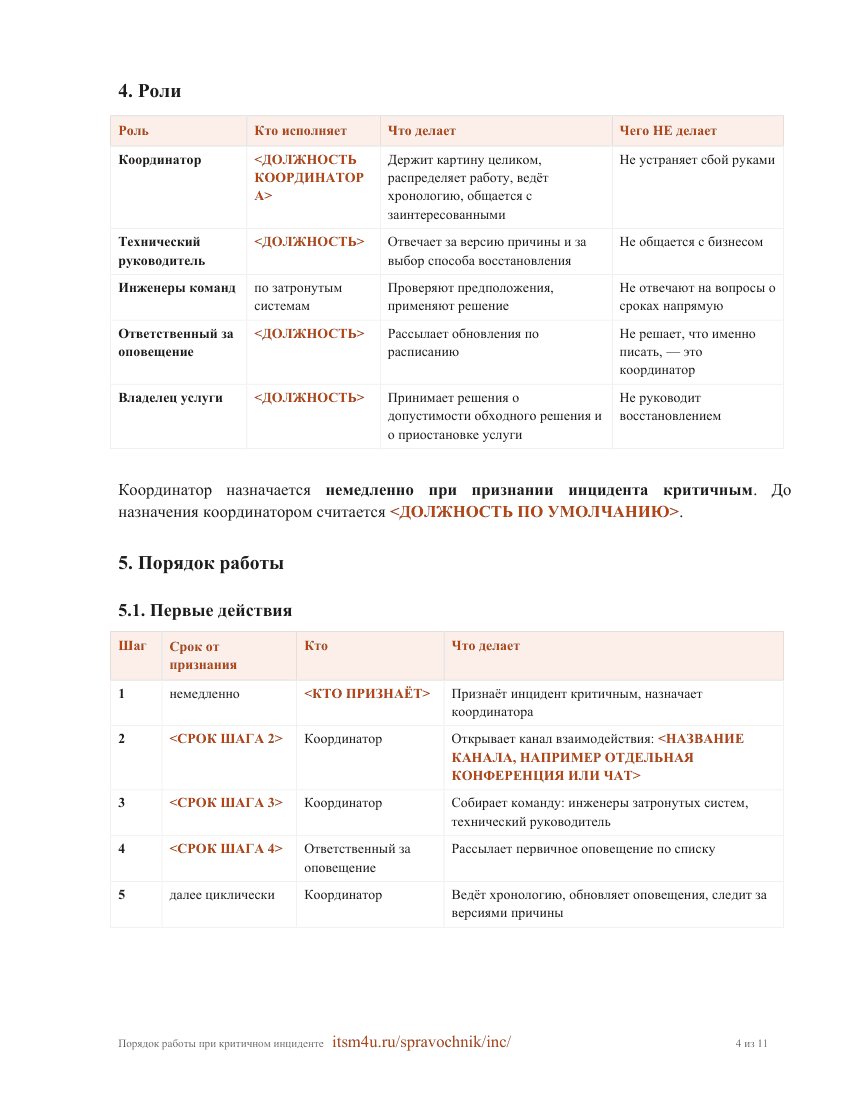
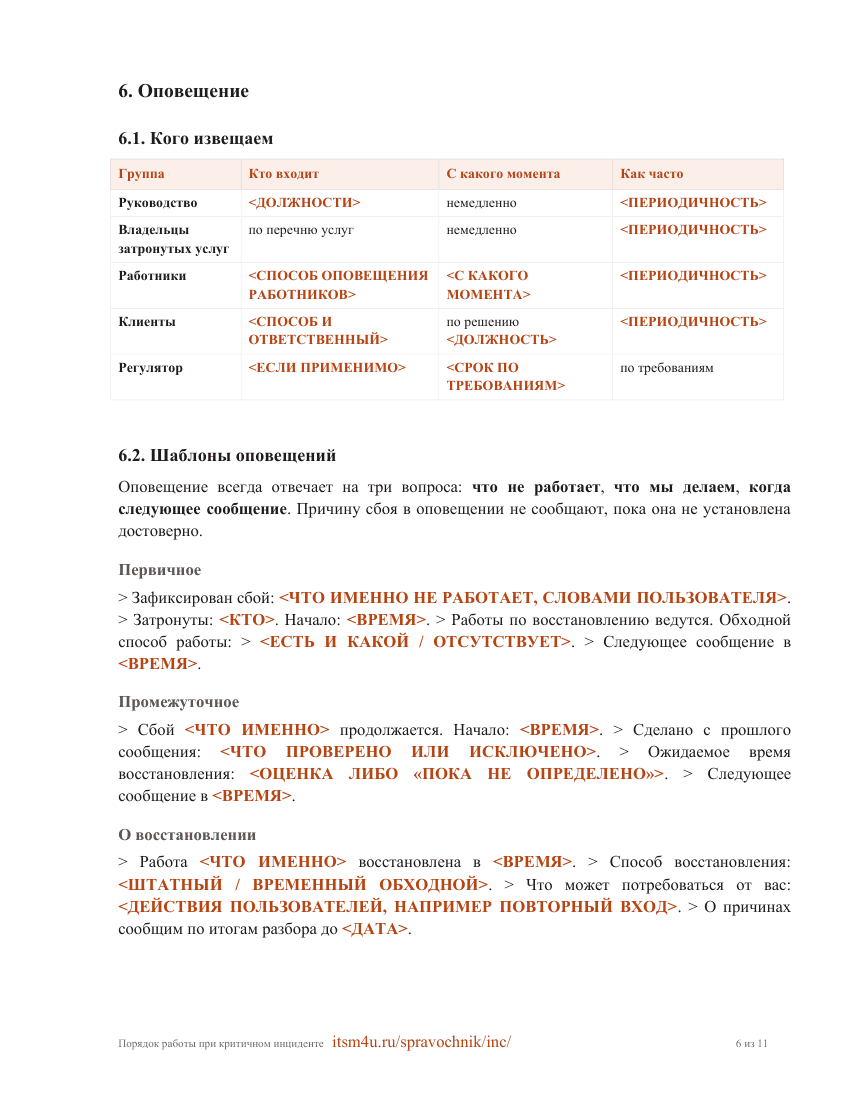
Порядок работы при критичном инциденте
Признаки, роли, первые действия, шаблоны оповещений
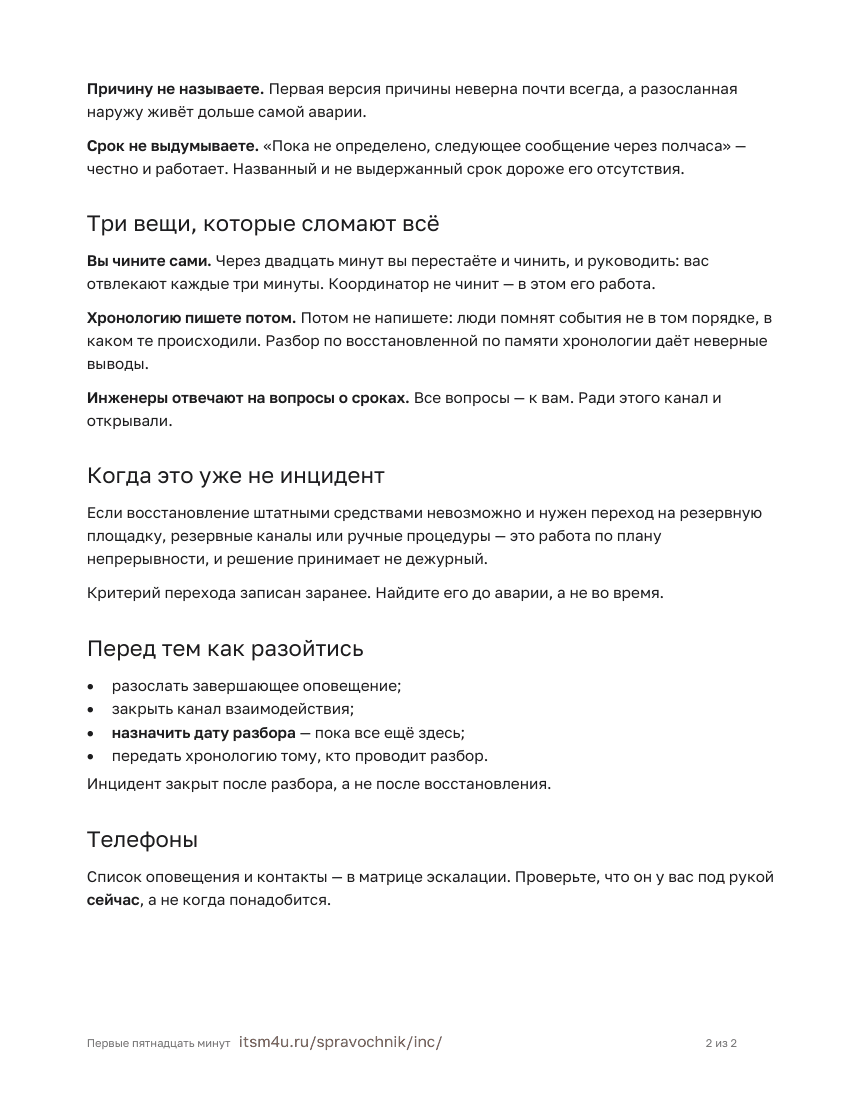
Первые пятнадцать минут
Что делает дежурный в первые пятнадцать минут. На стену
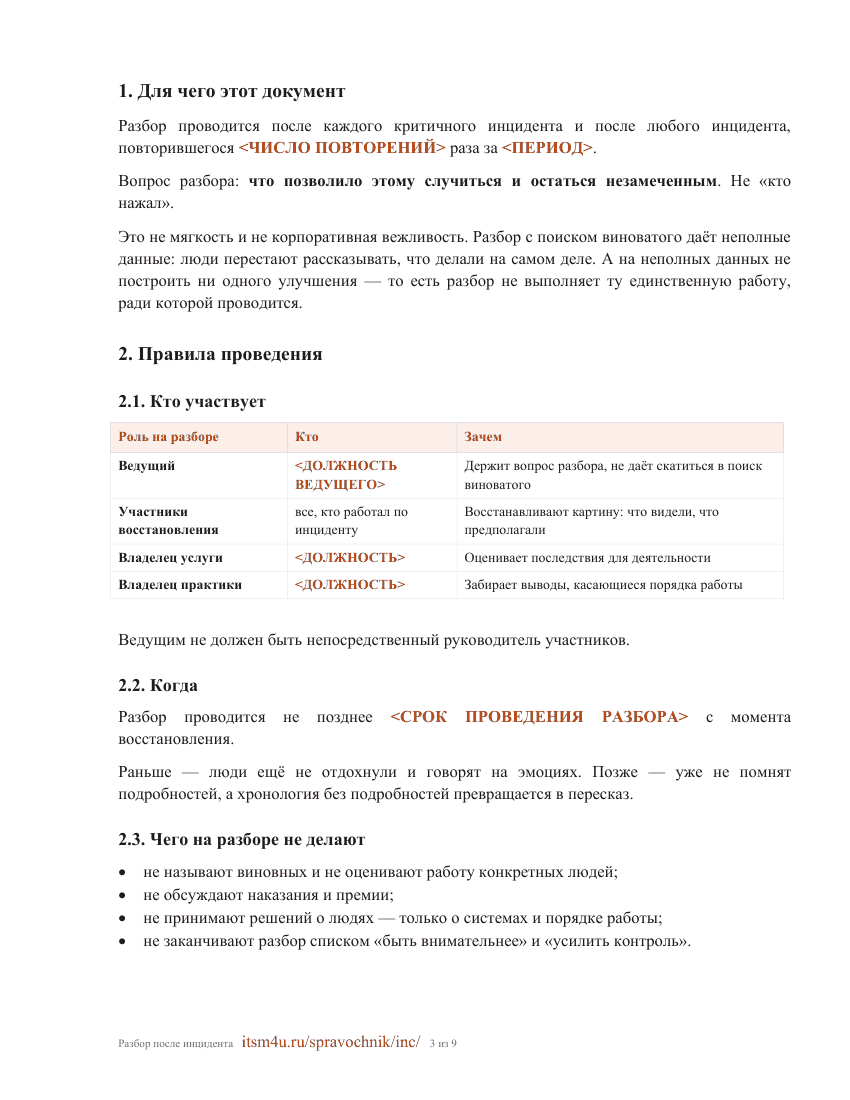
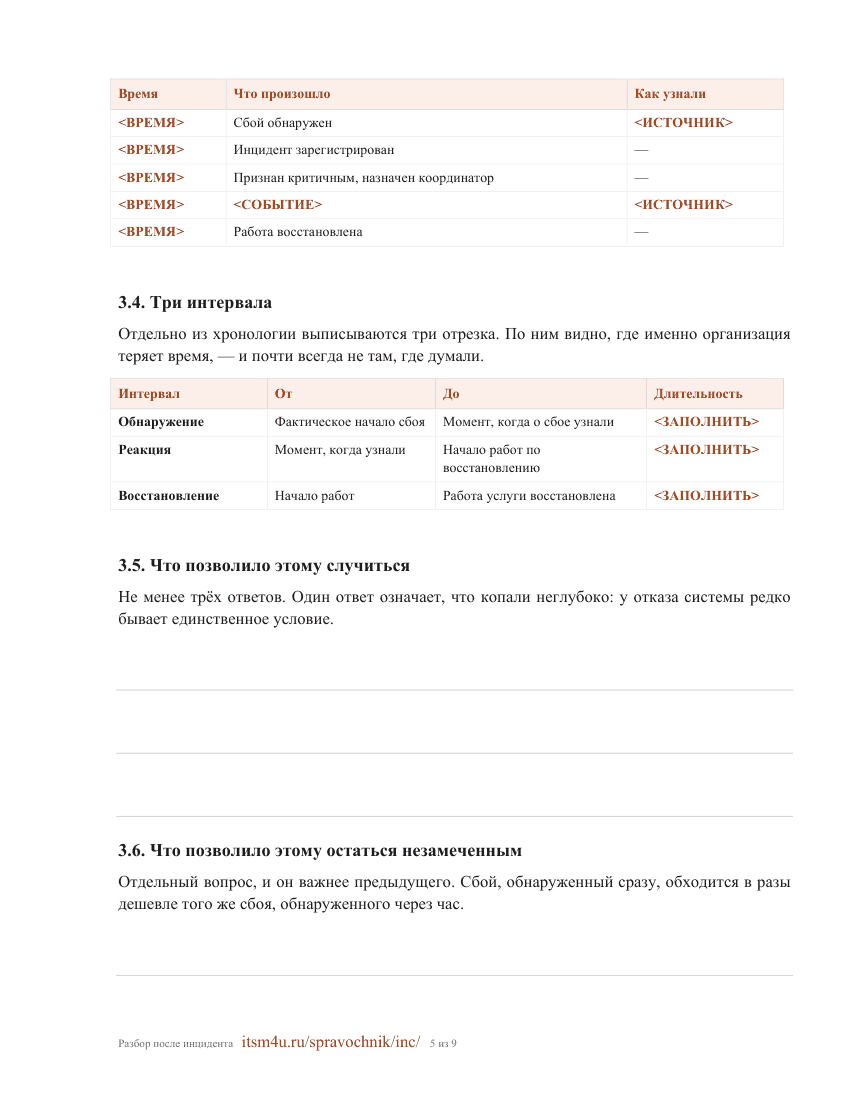
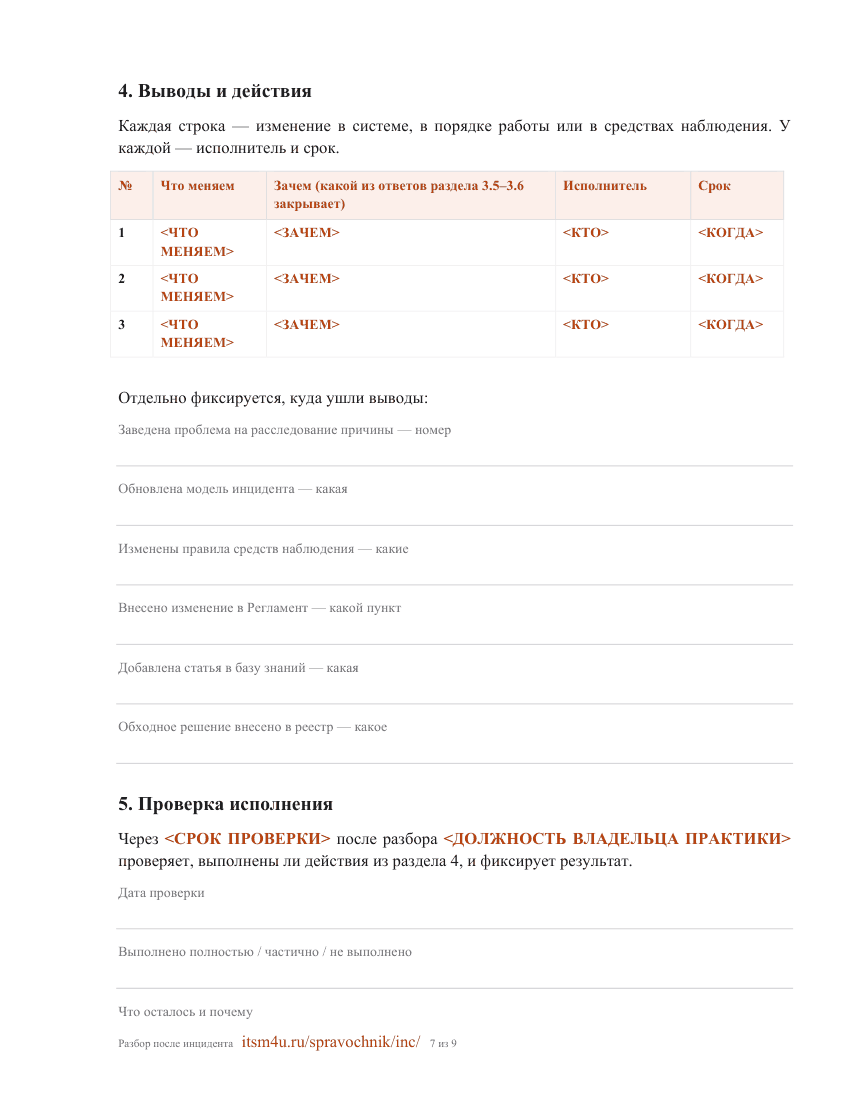
Разбор после инцидента
Форма разбора без поиска виноватых и проверка исполнения выводов
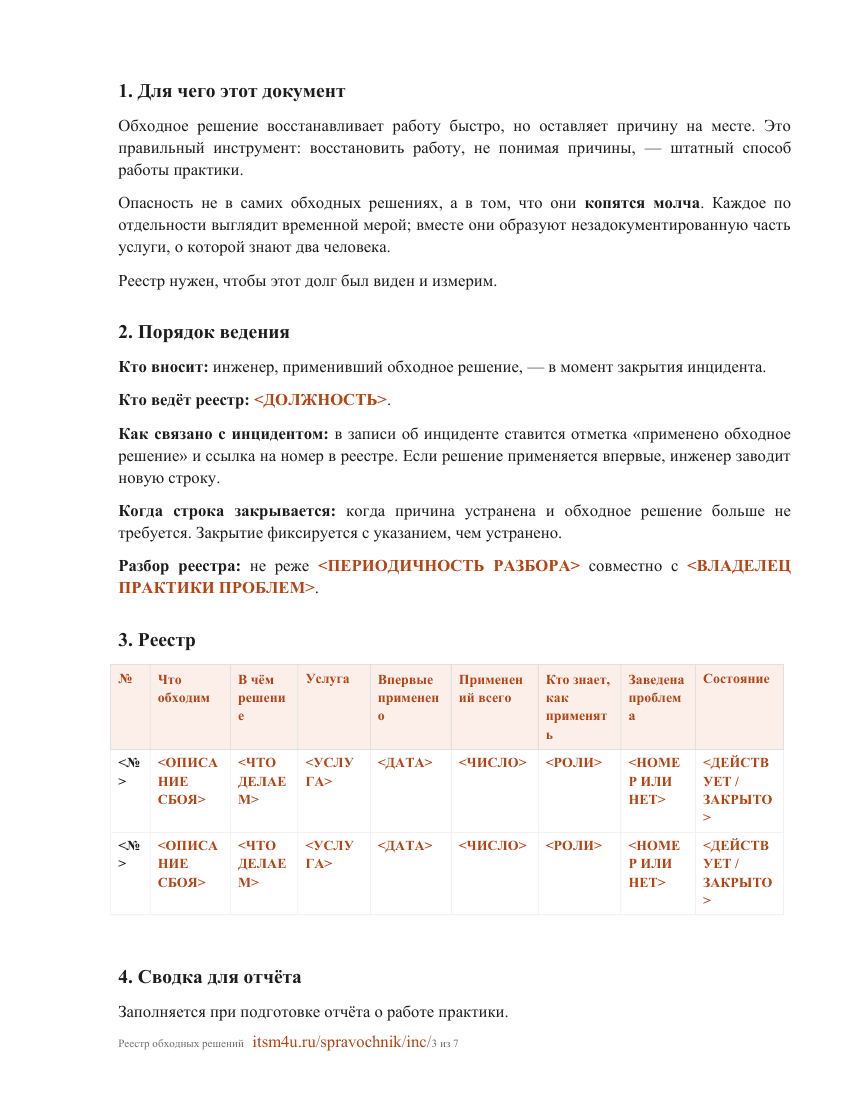
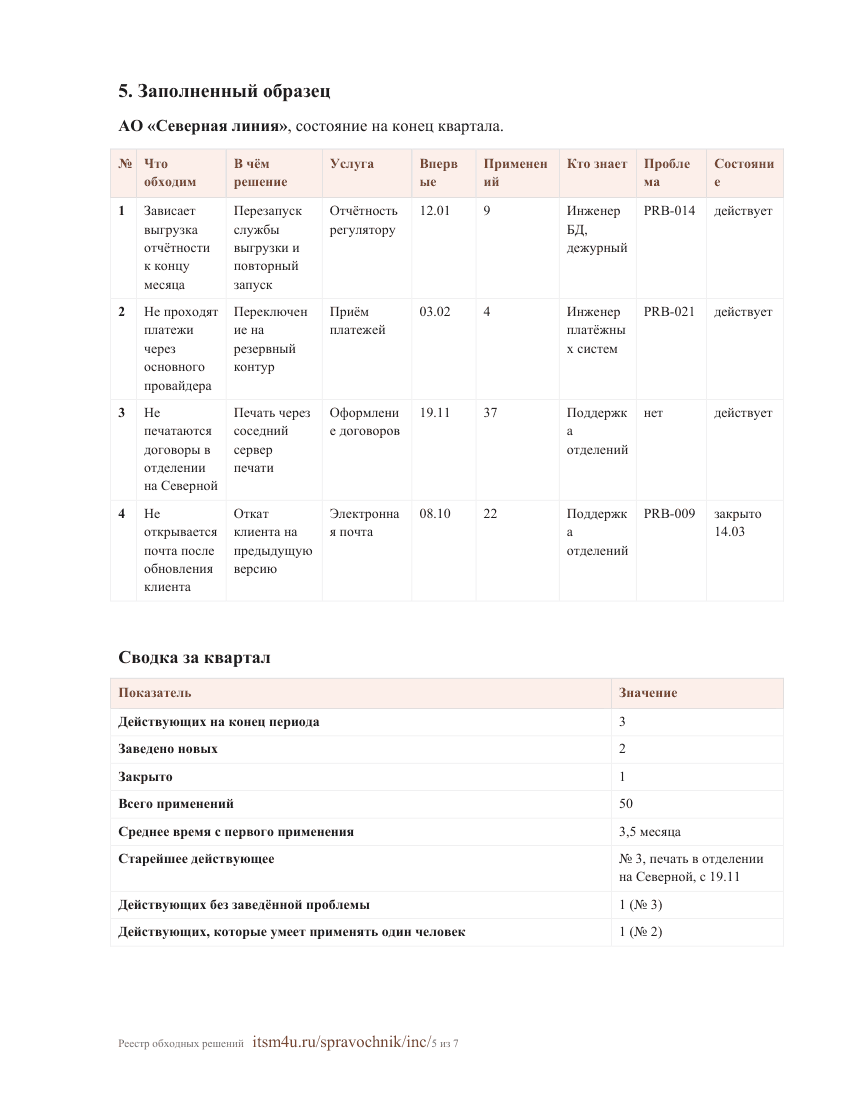
Реестр обходных решений
Учёт технического долгаТехнический долгНакопленный объём доделок, возникший из-за выбора быстрых обходных путей вместо системных решений.ITIL 4, практическое руководство по управлению инцидентами: три числа, по которым он виден
Измерение
Что считать, как читать и что показывать руководству
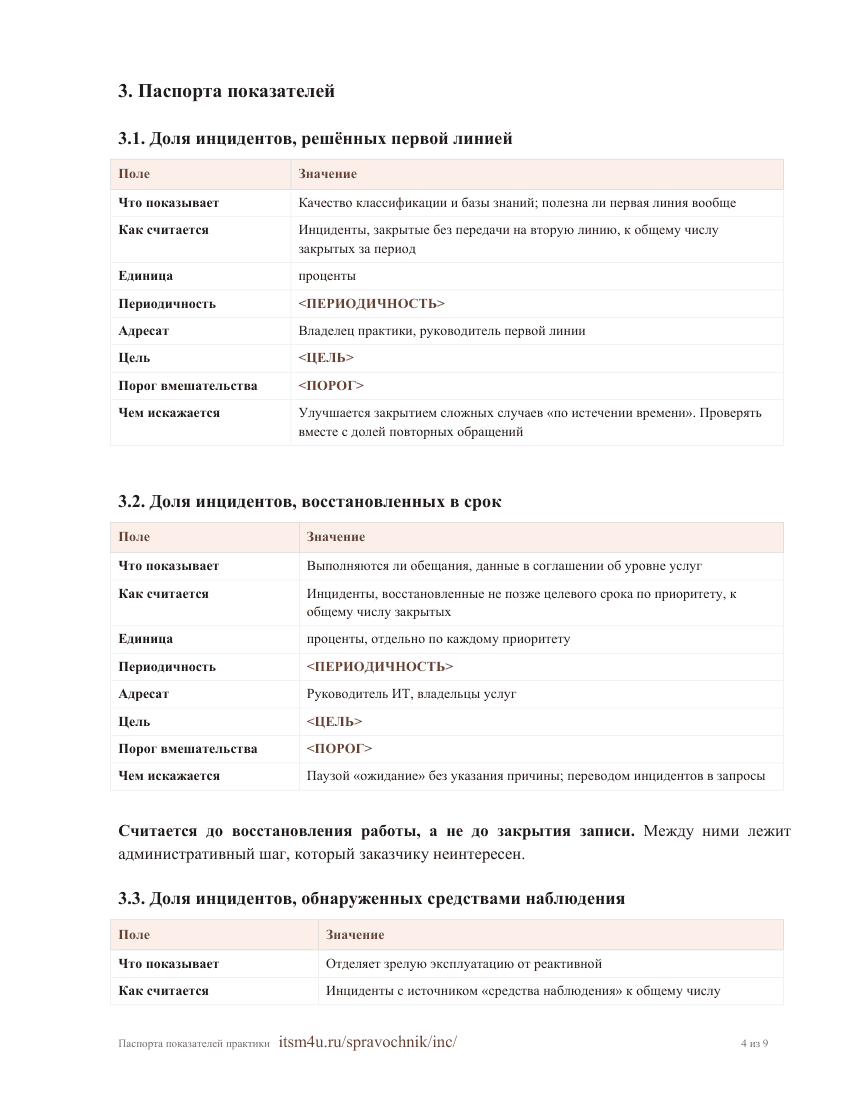
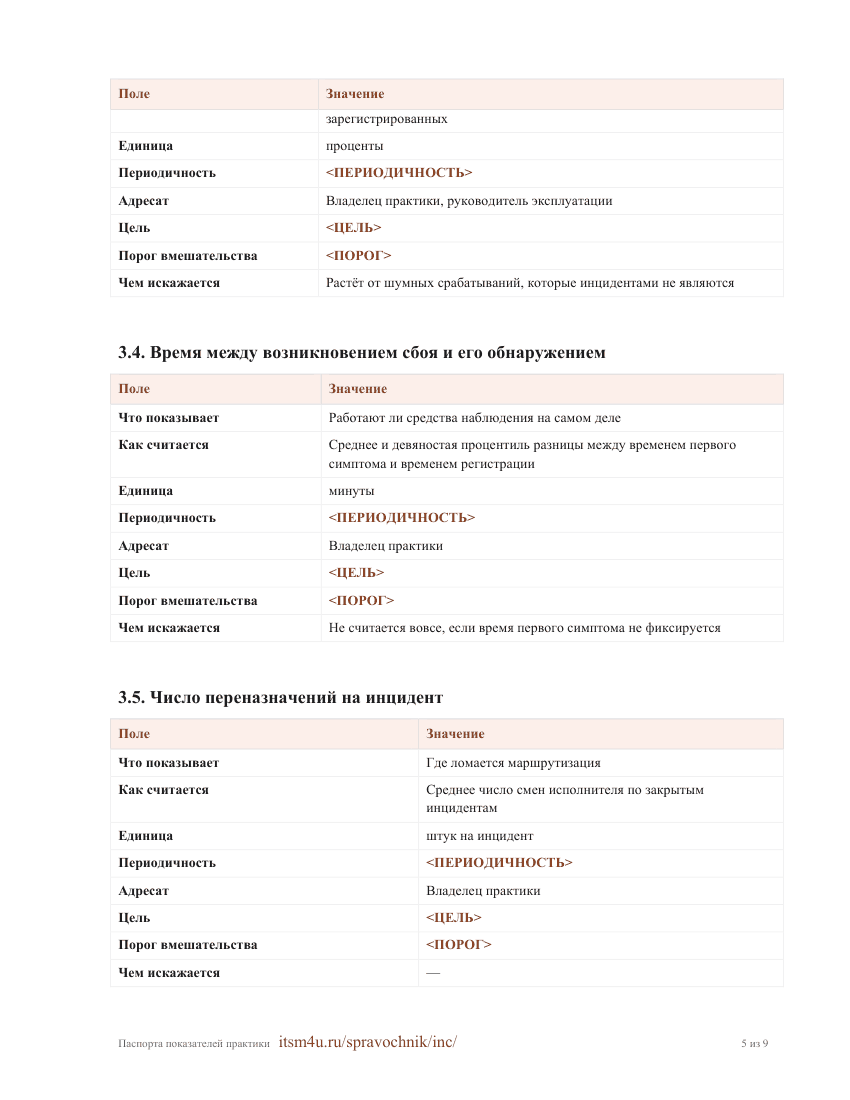
Паспорта показателей практики
Девять показателей: цель, порог, адресат, чем искажается
Как читать показатели практики
Почему падение показателя бывает хорошей новостью
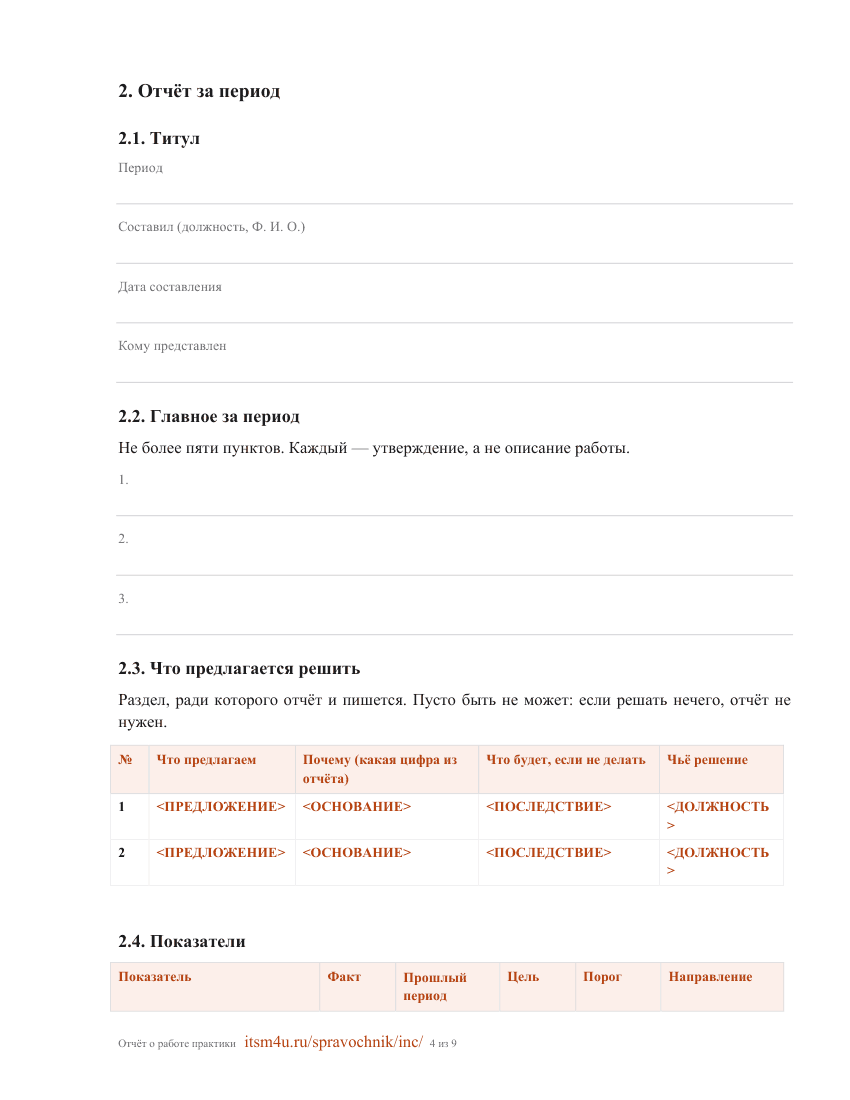
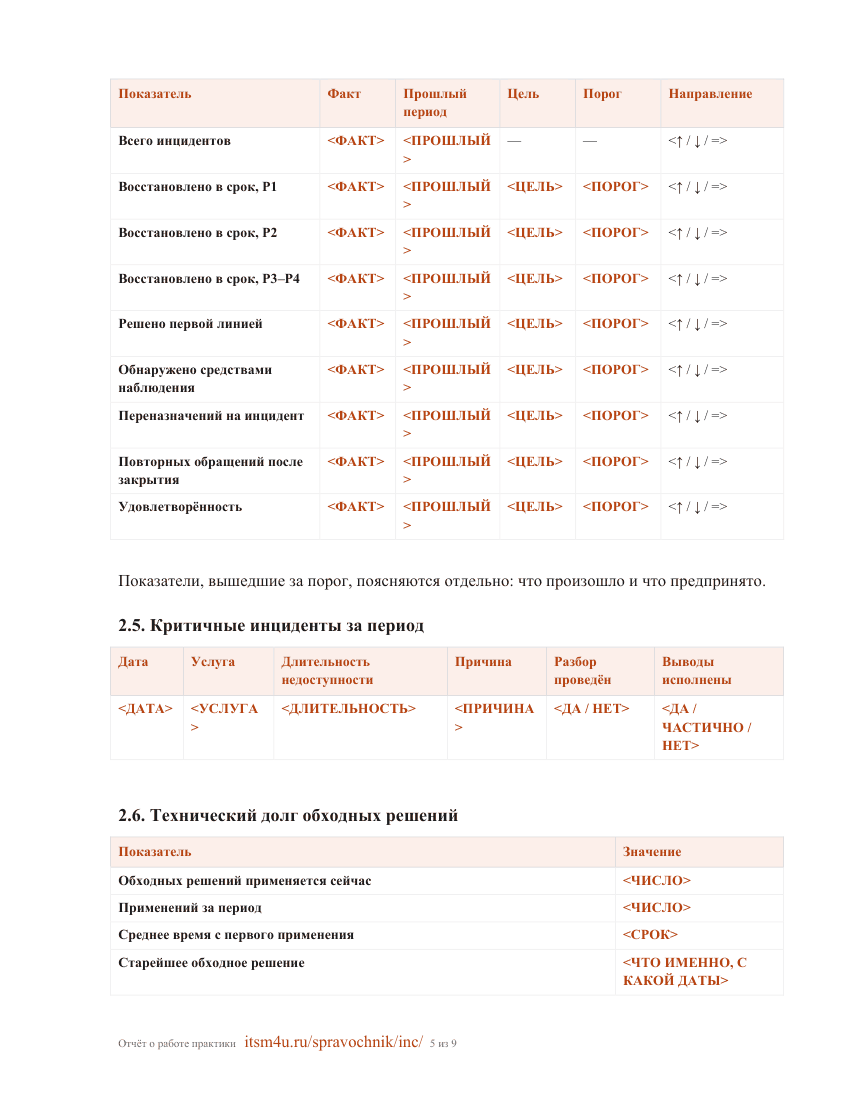
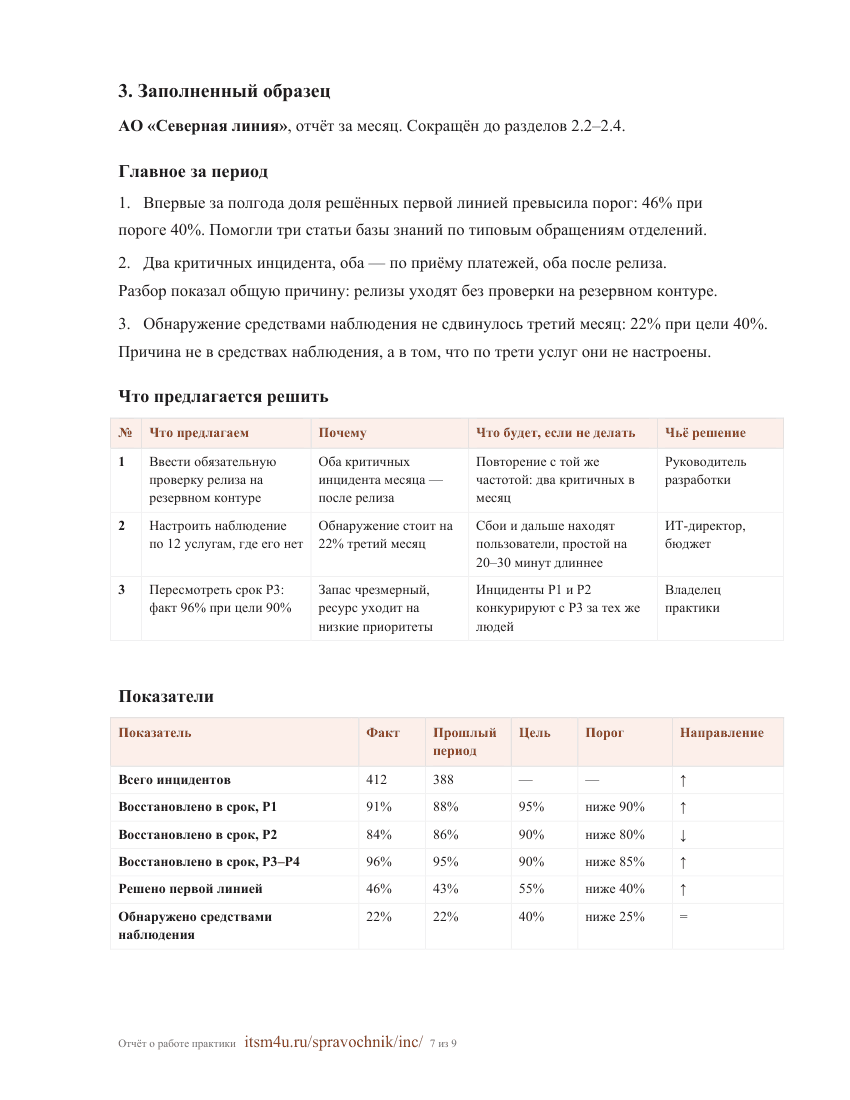
Отчёт о работе практики
Форма отчёта, который заканчивается решениями, а не таблицей
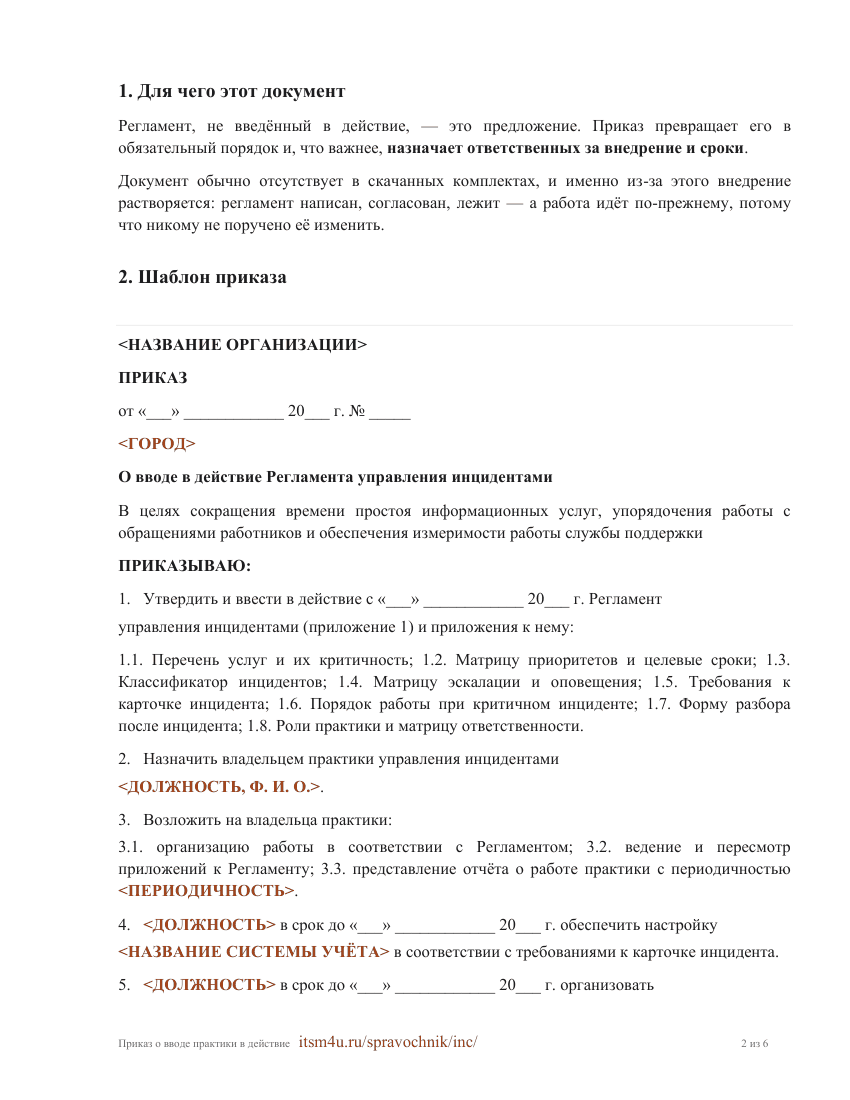
Ввод в действие
Чем практика запускается и как проверить, что она работает
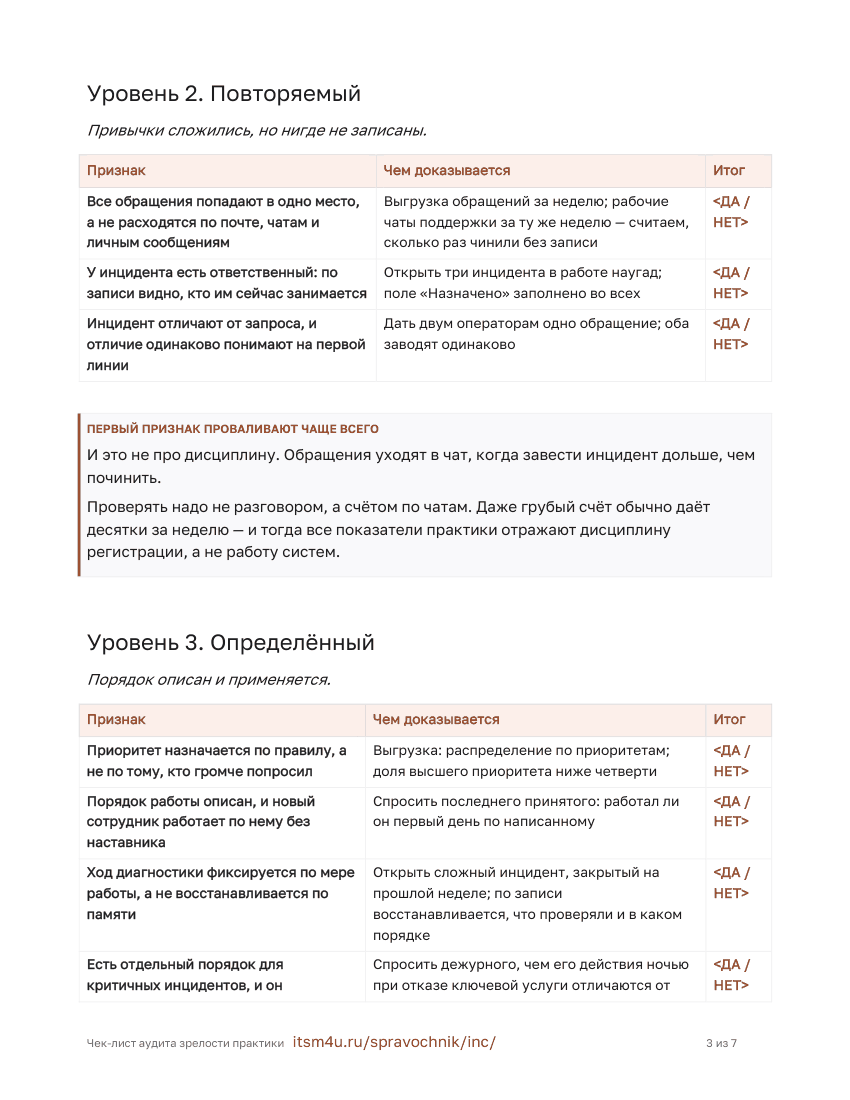
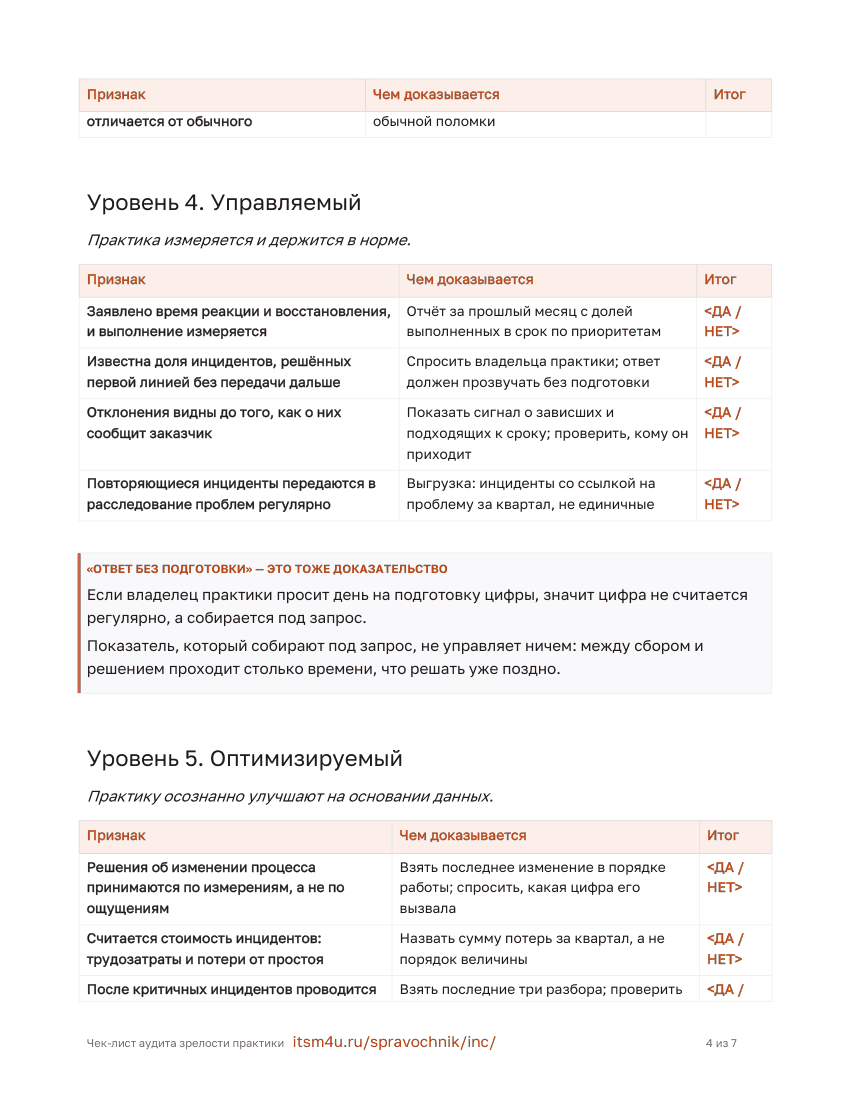
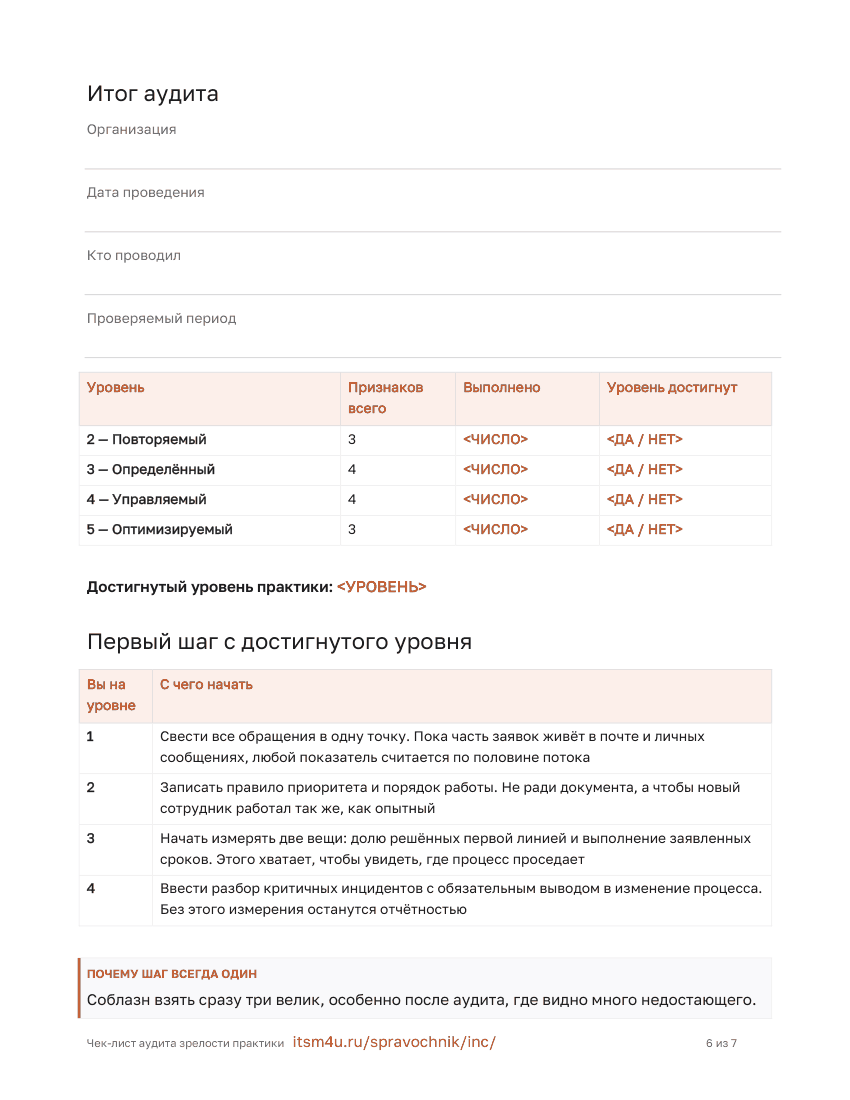
Числа в шаблонах не проставлены намеренно. Сроки, пороги и численность зависят от вашей организации, и заимствованный срок — это обещание, которое никто у вас не выбирал и не сможет выдержать. Там, где нужно решение, стоит подстановка, а перечень подстановок идёт последней страницей каждого документа.
Кто в этой практике
Роли размечены так же, как на нашей странице «Роли и практики»: за что должность отвечает, в чём участвует и что ей достаточно понимать. Название ведёт на её путь развития.
Отвечает 1
- Руководитель поддержкиС него спросят, почему сбой длился три часа. Всё, что он может предъявить, — заведённый порядок разбора и записи в нём.
Участвует 5
- Специалист поддержкиЭто его работа целиком: принять, восстановить, записать. Практика говорит, что именно записать, чтобы потом нашлось.
- Руководитель эксплуатацииПоловина инцидентов приходит из инфраструктуры. Отсюда видно, что ломается чаще всего и во что это обходится.
- Процессный методологОн этот порядок и описывает. Здесь лежит образец, от которого можно отталкиваться, а не изобретать с нуля.
- Руководитель информационной безопасностиИнцидент безопасности идёт по тому же пути, что и любой другой, но с другими сроками и другим кругом посвящённых.
- Руководитель SRE и платформыЕму нужен разбор без поиска виноватых и данные о сбоях, из которых считается бюджет ошибок.
Должен понимать 9
Разметка ролей — из нашего разбора компетенций: 19 ролей рынка и практики каждой.
Материалы по теме
Разборы и статьи
- Инцидент в ITSM: не просто сбой, а точка роста EvaTeamПро разбор после восстановления — то, что чаще всего пропускают
- Управление инцидентами и проблемами в ITSM ИнфраМенеджерРазделение двух практик на практических примерах
- Управление инцидентами в 2026: процессы, системы, инструменты SimpleOne 2026Крупные инциденты и сессии свормингаСвормингСовместный разбор сложного инцидента, где собирают не много людей, а нужных.ITIL 4, практическое руководство по управлению инцидентами
Видео и доклады
- Управление инцидентами Про ITSM, YouTube ноябрь 2020Базовый разбор понятия и процесса
- Что такое инцидент: разбор вопроса экзамена ITSM Foundation YouTube апрель 2024
- Реагирование на инциденты: процессы и люди AM Live март 2025Про команды и дежурство, а не про инструменты
- Построение процесса управления инцидентами ИБ Security Vision ноябрь 2025Смежная область: инциденты информационной безопасности
Деловые игры
- «Аполлон-13» — ITSM на практике ClevericsАвария на корабле разбирается как крупный инцидент: координация, обходное решение, работа в жёстких ограничениях. Эксплуатация, служба поддержки, инциденты и изменения за один день
- «Проект Феникс» ClevericsПро поток работы и узкие места; инциденты здесь — источник срыва планов, а не отдельная тема
Где научиться
- ITIL 4 Practitioner: Incident Management PeopleCert англ.Официальная сертификация по самой практике
- Документация по управлению инцидентами SimpleOneКак процесс выглядит в реальной системе, с полями и статусами
Что почитать дальше
Начинать стоит с официального практического руководства ITIL 4 1: оно короткое — в редакции 2020 года тридцать пять страниц — и написано как рабочий документ, а не как учебник.
Вторым — процессное руководство Стейнберга 6. Оно старше и относится к третьей редакции, но там подробно расписано то, чего в новом руководстве нет: конкретные процедуры, формы записей, правила эскалации.
Если нужен пример настоящего внедрённого регламента, а не образца, — описание процесса Fermilab 8: живой документ конкретной лаборатории, со всеми компромиссами внедрения.
По-русски систематическое изложение есть у Елхимова 9.
Про измерения — Брукс 13. Приложение A целиком про метрики управления инцидентами, и ценно оно не списком показателей, а тем, что у каждого расписаны обоснование, адресат, ограничения и два числа: цель и порог вмешательства. Такой разбор ценнее готового набора: набор устареет, а способ проверять метрику на пригодность — нет.
А для раздела «где ломается» полезнее всего не итсмУправление ИТ-услугами (ITSM)Управление ИТ как набором услуг: услуги перечислены, уровень каждой согласован, сбои и запросы идут по правилам.ITIL 4, книга ITIL Foundation; ГОСТ Р ИСО/МЭК 20000-1-2021; FitSM-0 «Обзор и словарь»; «Простой USM» (Ахонен, ван Бон)-литература, а книги про эксплуатацию: «Философия DevOps» 10 и «Хаос-инжиниринг» 11 — обе про то, как системы отказывают на самом деле, а не как это описано в регламенте.
Источники
- AXELOS. Incident Management. ITIL 4 Practice Guide. 2020. Разбор опирается на редакцию 2020 года. В 2023 году руководство пересмотрено: глав стало восемь вместо шести, добавлены оценка зрелости и рекомендации. Правообладатель ITIL с 2021 года — PeopleCert, а не AXELOS. об издании у правообладателя
- Microsoft. Microsoft Operations Framework 4.0. SMF-функция «Обслуживание заказчиков». 2008. Управление инцидентами в MOF живёт здесь. Распространяется по лицензии Creative Commons с указанием авторства для некоммерческого использования. скачать архив MOF у Microsoft
- Microsoft. Microsoft Operations Framework 4.0. Обзор. 2008. Общее устройство свода: этапы, уровни, связь функций между собой. скачать
- ISACA. COBIT 2019 Framework: Governance and Management Objectives. 2018. Правообладатель отдаёт книгу бесплатно и не-членам ISACA — через оформление заказа в своём магазине. Ядро свода: сорок целей руководства и управления, у каждой практики, действия, входы и выходы с адресом конкретной соседней цели. издание у правообладателя, скачивание бесплатное
- ISO/IEC. ISO/IEC 20000-1:2018. Information technology — Service management. 2018. Требования к системе управления услугами, включая управление инцидентами. Действует редакция 2018 года с поправкой Amd 1:2024. карточка стандарта в ISO
- Steinberg R.. Incident Management Process Guide. 2006. Подробное процессное руководство эпохи третьей редакции: процедуры, формы записей, правила эскалации.
- IT Training Zone Ltd.. Module 3 Study Guide: Incident Management. ITIL Capability — Operational Support and Analysis. 2012. Учебный материал курса.
- BMC Software Consulting Services. Fermilab Computing Division: Incident Management Business Process and Procedure. Регламент реальной организации, а не образец: виден каждый компромисс внедрения.
- Елхимов С. В.. Свободный ITIL. 2017. Систематическое изложение по-русски.
- Дэвис Дж., Дэниелс К.. Философия DevOps. Искусство управления IT. 2019. Издательство «Питер». Полезна описанием того, как системы отказывают на самом деле.
- Розенталь К., Джонс Н.. Хаос-инжиниринг. Революция в разработке устойчивых систем. О намеренной проверке систем на отказ — обратная сторона управления инцидентами.
- AXELOS / Best Management Practice. ITIL Service Operation (издание 2011 года). 2011. Канонический источник по управлению инцидентами эпохи третьей редакции. Раздел 4.2.8 задаёт метрики не списком, а через факторы успеха: сначала что должно быть верно, потом чем это измеряется.
- Брукс П.. Метрики для управления ИТ-услугами. 2008. Русское издание в серии «Библиотека IBS», оригинал — Peter Brooks, Metrics for IT Service Management, Van Haren Publishing, 2006. Приложение A целиком посвящено метрикам управления инцидентами: у каждой метрики указаны описание, обоснование, аудитория, ограничения, опасное и целевое значения. оригинал у издателя Van Haren
- PeopleCert. ITIL FAQ. Правообладатель ITIL. Здесь объявлены параллельное хождение ITIL 4 и ITIL (Version 5) и дата, после которой ITIL 4 не поддерживается.
- Росстандарт. ГОСТ Р ИСО/МЭК 20000-1-2021, пункт 8.6.1 «Управление инцидентами». 2021. Русская редакция того же стандарта, что и запись [5]: перевод идентичный (IDT). Введён в действие 30 апреля 2022 года приказом Росстандарта от 7 декабря 2021 года № 1718-ст. Взят потому, что англоязычное издание платное и открытой копии не имеет, а русский текст требований есть в библиотеке. действующий национальный стандарт, идентичный ISO/IEC 20000-1:2018